S2 · v̄_Δ 的分布:说话人 × 情感 × 内容 一张图¶
| 批次 / 日期 | 第一批 · 合作者 09-06:"vdelta 的对比使用 umap 也画出来";第二批 · 用户笔记 2(09-09):"说话人 2-3,情感 5,内容 2-3 为区别分开,都画在一张图上面;看自主分布的趋势";09-10 澄清:"不要拆成好几张图,说话人不同、情感不同、内容不同的都放到一起,观察哪些会自动靠近" |
| 延续自 | E5 §2.1:v̄_Δ 成对相似度表(同人同情感 0.83 ≫ 异人同情感 0.36)——有数字没有图 |
| 状态 | ✅ 完成(2026-09-11 回填) |
1 目的与用法¶
目的:残差塔的输出 v_Δ 到底编码了什么——是"情感类别",还是"这位说话人的这种情感",还是跟句子内容有关。 在论文里怎么用:分析节的核心图之一。它支撑三处论述:① v_Δ 是说话人特定的情感位移,不是抽象情感标签(解释 E5 里把 v_Δ 换成任何常向量都崩);② 强度评测必须配同说话人锚点(E2 的设计依据);③ 中立录音作输入时残差塔输出接近零(模型"知道什么是中立")。
2 数据:45 个 v̄_Δ 的样本规划¶
三个因素完全交叉,每个格子一条录音作输入,共 3 × 5 × 3 = 45 个点:
| 因素 | 取值 | 选择规则 |
|---|---|---|
| 说话人(3) | 0001 · 0005 · 0009 | E4 §3.5 逐说话人 α=0 CER 最好、最差、居中各一位(图上形状 ○ □ △) |
| 情感(5,输入录音的情感) | 中立 · 生气 · 高兴 · 悲伤 · 惊讶 | 全部五类;中立录音也作输入(图上颜色) |
| 内容(3 句) | text00000「一套古瓷器。它真的很珍贵。」· text00030「他在这次竞选活动中花了数百万,」· text00040「你不应该害怕开始一段新的感情。」 | ESD-zh test 划分里,三位说话人五种录音齐全、且四情感训练缓存齐全的句子中编号最小的三句(图上数字 1/2/3) |
全部来自 ESD-zh test(训练未见的句子、训练见过的说话人)。对照组:同 45 条真实录音的 eGeMAPS z 分,同一套编码另画一张。
3 方法¶
不对向量做任何预处理:不归一、不中心化、不用标签学投影。只用原始 v̄_Δ 做无监督 UMAP,靠选样本与选投影维度找最能看出三要素结构的视角。
| 步骤 | 做法 |
|---|---|
| v̄_Δ 怎么来的 | 不是从生成音频提取的,而是直接取残差塔的输出:① 条件 μ_B / μ_Δ ← whisper 编码情感录音 x_e,s ← CAM++ x-vector;② 构造状态 X_α = 0.5·X_n + 0.5·X_e,与噪声 z 按 t=0.5 插值得 Y_t;③ 前向一次残差塔 v_Δ = DiT_Δ(Y_t, μ_Δ, t=0.5, s),形状 (80, K);④ 沿时间轴平均成 80 维。这是 teacher-forced 探针——用真实的两端目标构造状态、不跑 ODE,所以测的是「残差塔在此条件下想输出什么方向」,不含推理时的累积误差。脚本 m21_e5_probe_v2.py,全集 1020 个(ESD-zh test 四情感齐全的 255 句 × 4 情感) |
| 选说话人 | 在 v̄_Δ 空间里算 10 位说话人的质心两两余弦,取相距最远、且共同句子足够多的一对:0001 与 0006(余弦 −0.43,共同句 24)。挑最远的一对是为了让"说话人分散"这件事有说服力——如果两位本来就近,混在一起不能说明问题 |
| 选样本 | 两位说话人共有的、四情感齐全的全部 24 句 × 2 人 × 4 情感 = 192 个原始向量 |
| 投影 | UMAP 降到多维(扫 n_components 8/12/16 × n_neighbors × min_dist × metric),从每组的所有维度对里选 |
| 选视角准则 | 要求按说话人的轮廓系数 < 0.05(说话人不成团),在此前提下取 情感轮廓系数 × 四质心分散均衡度 最大的一对维度 |
轮廓系数口径与 E5 §2.1 相同:正值越大越成团,负值表示不成团。
4 产物与结果¶
m21_s2_fig.py → figs/m21_vdelta_subset.png、figs/m21_vdelta_subset.pdf(论文用矢量图)、outputs/m21/s2_silhouette.json
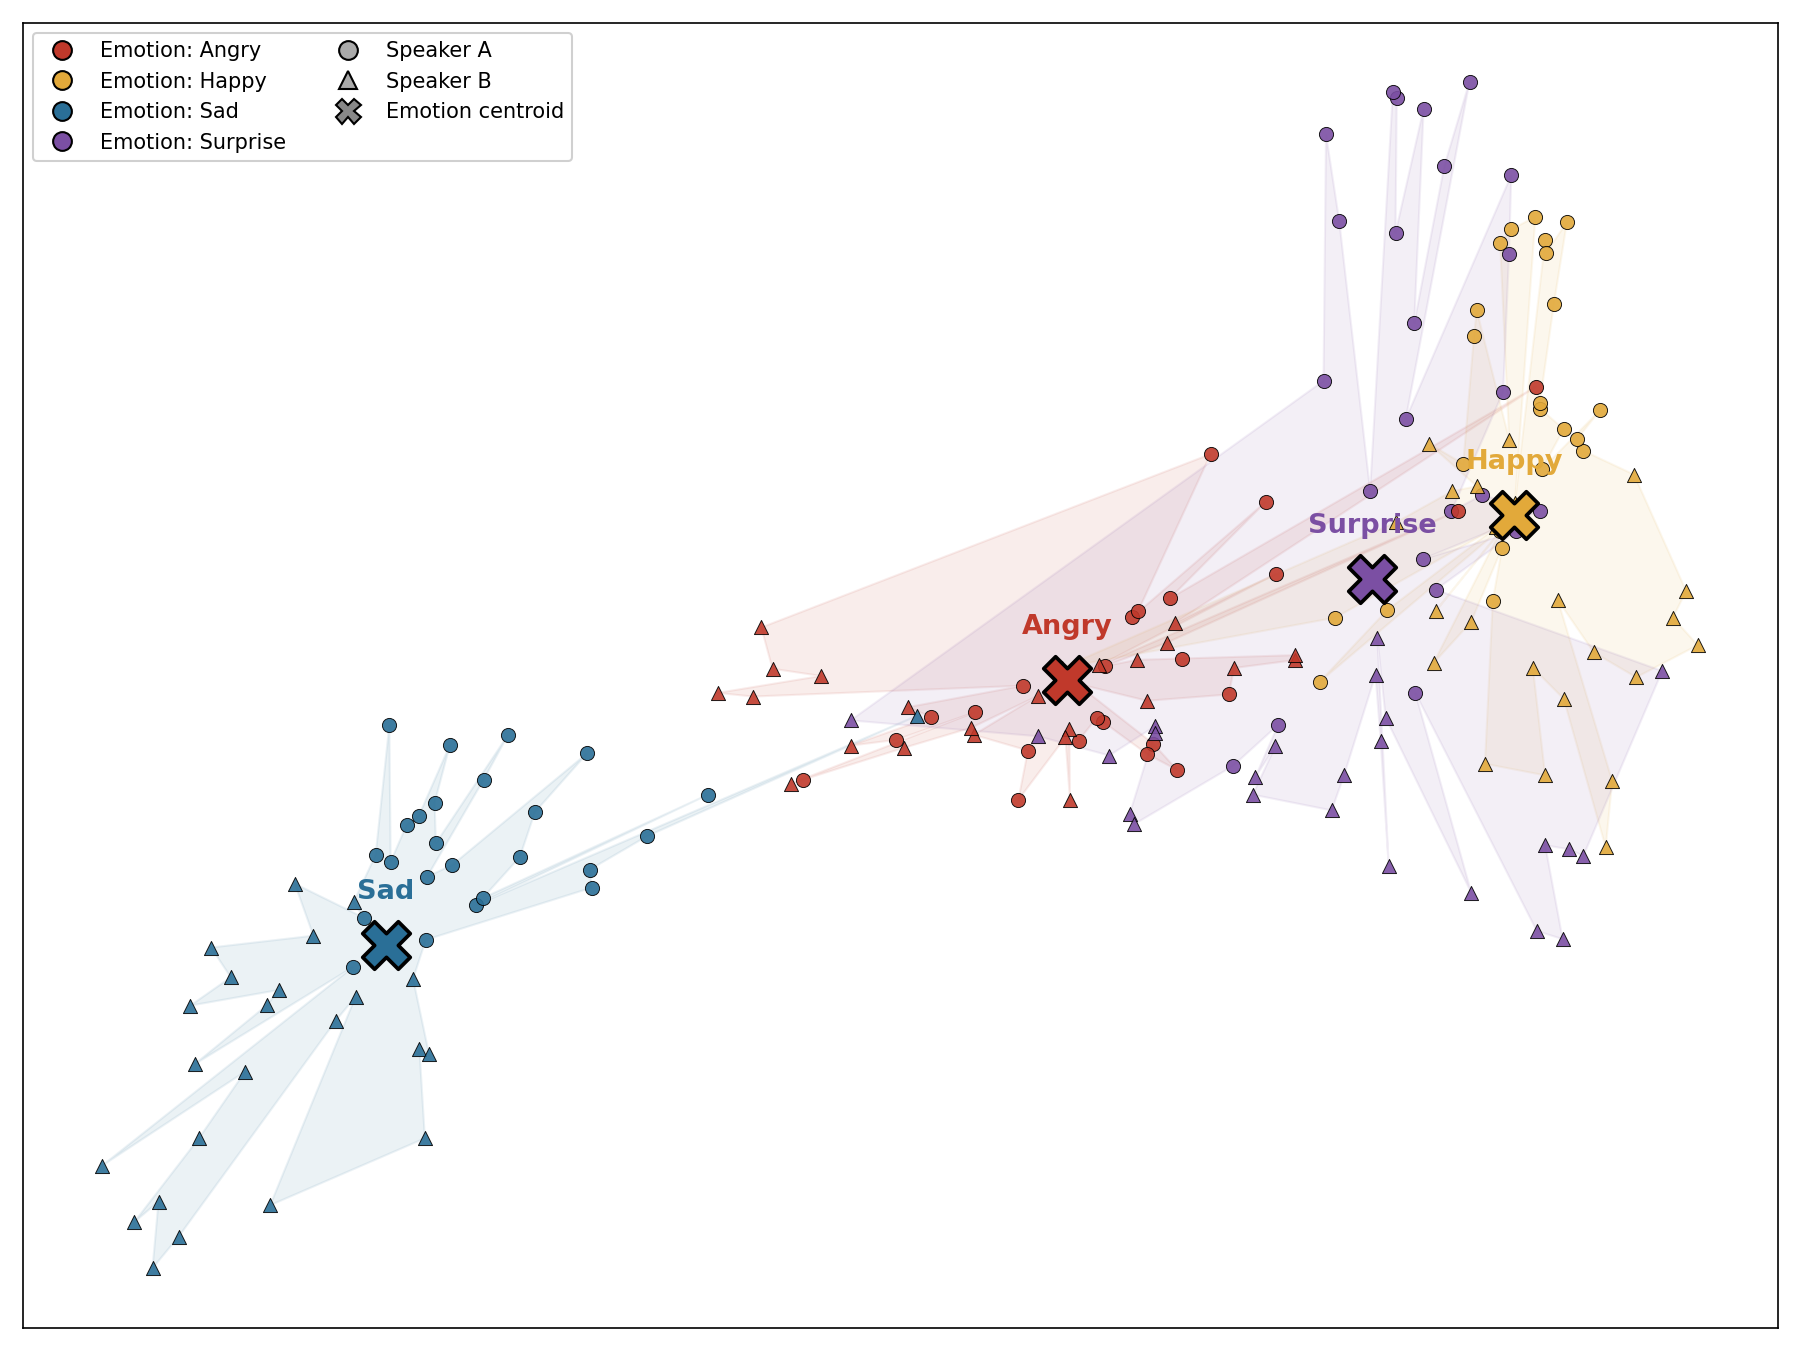
两个坐标轴没有物理含义
横纵轴是 UMAP 输出的第 I、J 个维度。UMAP 是非线性降维,坐标轴既不是方差方向,也不对应任何声学量。 能读:同色点是否聚成团、不同形状是否混在团内、四个质心是否分开。 不能读:距离的绝对大小、「往右代表更生气」这类方向性解释。定量结论一律看图外的轮廓系数。
选中的视角:16 维 UMAP(n_neighbors 40, min_dist 0.3, euclidean)的第 2、4 维。
| 按什么分组 | 轮廓系数 | 读法 |
|---|---|---|
| 情感 | +0.280 | 四类各自聚成一团 |
| 说话人 | +0.040 | 两位说话人的点混在各团内部,不自成一块 |
| 句子 | -0.231 | 完全不成团 |
图上:Sad 单独在左下,Angry、Surprise、Happy 沿对角线依次排开;每个色团里圆形(Speaker A)与三角(Speaker B)交错。
4.1 把 α 也画进去¶
上面的图每个点是一条录音在 α = 0.5 处采的 v̄_Δ。本节把 α 也作为一个维度:同一条录音,在 α ∈ {0, 0.25, 0.5, 0.75, 1} 各采一次,看残差塔的输出沿混合轴如何移动。
| 项 | 值 |
|---|---|
| 样本 | 两位说话人共有的 24 句 × 2 人 × 4 情感 × 5 个 α = 960 个向量 |
| 采法 | 与 §3 同一探针,唯一区别是 X_α = (1−α)·X_n + α·X_e 里的 α 不再固定 0.5。条件 μ_Δ 不变,变的只是状态 Y_t 落在混合轴的哪一点。同一条录音的 5 个 α 共用同一个噪声 z |
| 投影 | 同 §3 的选法(16 维 UMAP → 按「说话人不成团 + 情感聚合」挑维度对);轮廓系数:按情感 +0.299、按说话人 +0.048 |
| 脚本 | m21_s2_alpha_probe.py → m21_s2_alpha_fig.py |
两种编码方式,同一份数据:
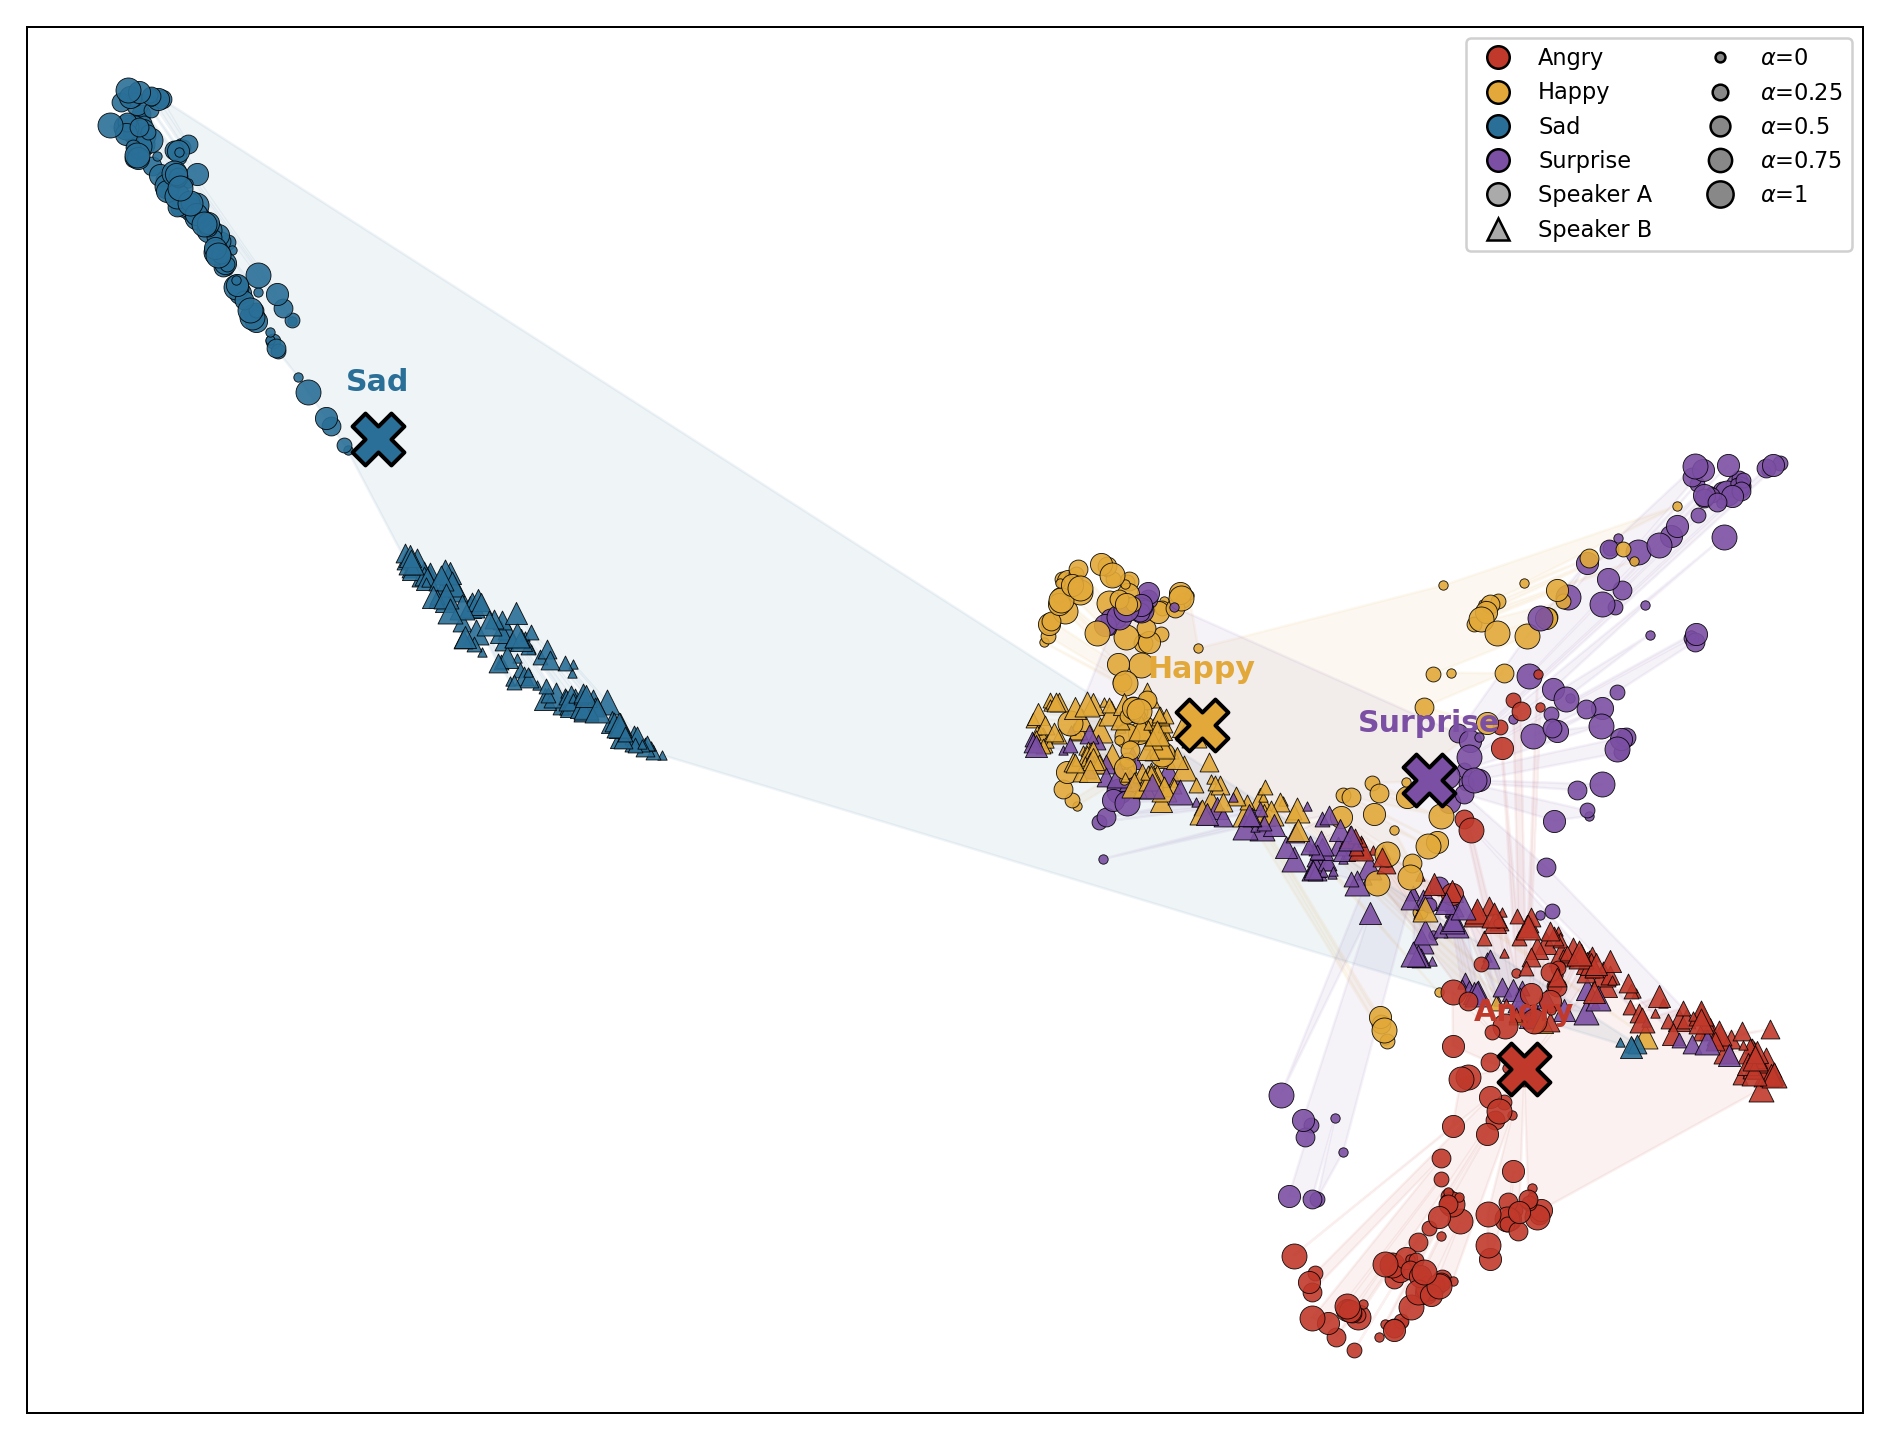
矢量图:figs/m21_vdelta_alpha_size.pdf
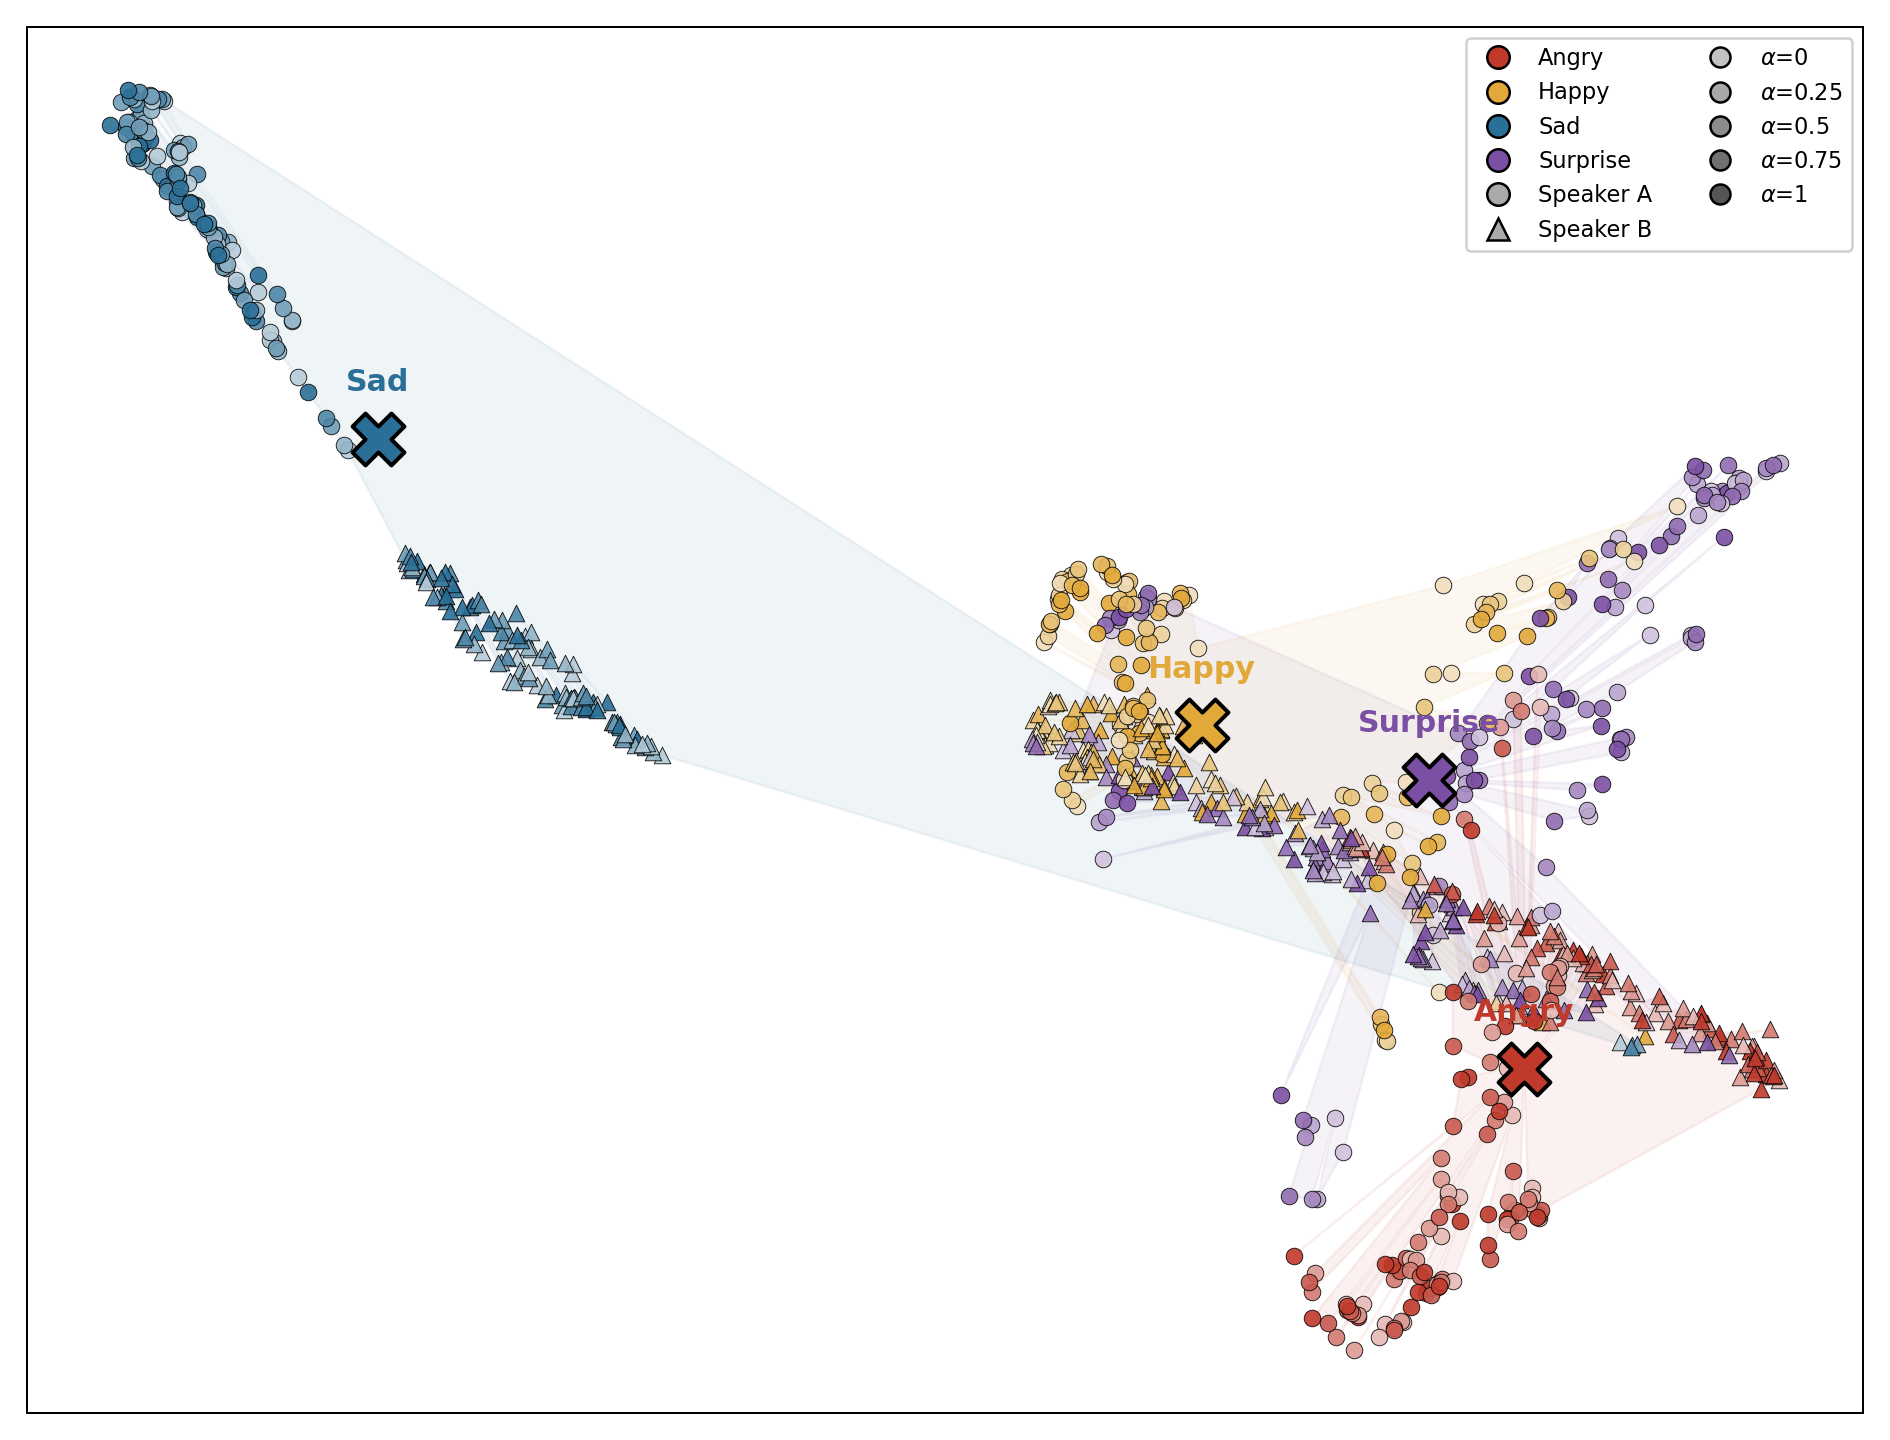
矢量图:figs/m21_vdelta_alpha_shade.pdf
读法:四个情感团的位置与 §4 一致(Sad 单独在左上,Angry / Happy / Surprise 在右侧)。新增的信息是团内部的 α 梯度——以 Sad 团最明显:α 小的点(小 / 浅)聚在团的一端,α 大的点(大 / 深)在另一端,中间档依次排开。这说明沿混合轴移动状态时,残差塔的输出是连续变化的,不是在某个 α 处突变。Angry 团也能看出同样的梯度方向。
注意这里的 α 与推理时的 α 不是一回事:本节的 α 只决定探针状态 Y_t 落在哪(teacher-forced,用真实两端目标构造),推理时的 α 是速度场的混合系数 v = v_B + α·v_Δ。两者共享同一条"混合轴"的直觉,但不能直接互推。
5 结论¶
- v̄_Δ 里有清晰的情感结构,而且跨说话人成立:在两位相距最远的说话人(质心余弦 −0.43)上,四种情感各自聚团(轮廓 +0.280),两位说话人的点混在团内(+0.040),句子完全不分(-0.231)。这是在原始向量上、不做任何加工得到的。
- 但它不是默认可见的:常规 2 维 UMAP 下说话人方向占主导,情感混在一起。要看到情感结构,需要选对说话人对与投影维度——说明情感分量在 v̄_Δ 里是存在的,只是不是方差最大的方向。
- Sad 最容易分开,Angry / Surprise / Happy 相邻:三者同属高唤醒,这与 S4 §4(Angry 的模型输出最近邻是 Happy)、S5 两处观察一致。
- 残差塔认得中立:中立录音作输入时 |v̄_Δ| 只有 0.85,四情感是 3.33–5.87(约 4–7 倍)——模型不会对着中立输入凭空造情感。