M14 · 从 CosyVoice3 基座重训
| 状态 | ✅ 完成(2026-08-28) |
| 一句话 | 从 CosyVoice3 基座 flow 重训完整双路模型(R3 等长对、双支各自 token),λ_ortho ∈ {0, 0.1, 0.5, 1.0, 10} 平行训练,预算对齐 v4 |
| 上游 | ← M10–M13 均从 v4_epoch5.pt 续训;本实验按要求从基座重训 |
| 对照 | v4(同起点、同预算、旧训练法)· M13-λ0(同训练法、v4 起点) |
TL;DR
从基座重训成立;λ 全剂量域仍无情感效应。
- ✅ 基座起点不弱于 v4 起点:M14-λ0 vs M13-λ0(同法,仅换起点) delta 0.733 vs 0.572、受控 9/12 vs 7/12、MOS@α=0 3.69 vs 3.59 —— 此前对「v4 起点混淆」的担心解除,方法从零训成立
- ✅ α=0 音质达到 v4 水平:五臂 MOS@α=0 3.66–3.82(v4 = 3.74)
- ⚪ λ 五点扫描(0 → 10)零结果:训练侧剂量响应完整
(λ=10 把
L_ortho压到 0.019、cos_A_B−0.114,代价 L_FM +42%), 下游配对全部 <2σ 且点估计全为负 —— 「正交要从头参与训练才有用」这最后一条辩解也被排除 - 探针:情感专一性 gap 三 ckpt 全为负(−0.022 / −0.013 / −0.054)
- 代价不变:双路 CER 0.089–0.114(v4 共享路 0.043)
1 目的
M10–M13 的训练均从 v4_epoch5.pt 继续;本实验从基座重训同一方法,
使「vs v4」成为同起点、同预算的比较。
2 实验设置
2.1 数据
复用 M13 的 R3 缓存 data/m13_cache/(21,301 条,构造流程如下,本轮不重建):
对每个 (key, emotion) 训练对:
  1. 情感支:ESD 情感录音 → speech tokenizer → gen_token_e (N_e,);mel → x1_emo (2N_e, 80)
  2. 中性支:同 key 中性录音 → Rubber Band R3 变速(保音高)至 N_e/25 秒
             → 重新 tokenizer → gen_token_n (N_e,);重提 mel → x1_neu (2N_e, 80)
  3. 前缀:同说话人异文本录音一条(prefix_map 固定分配);
     其中性版同样 R3 变速至情感前缀时长后重提
  4. 断言:len(gen_token_n)==N_e 且 mel 帧数==2N_e,违例剔除
  5. 过滤:|N_e/N_n − 1| ≥ 0.40 剔除
缓存字段:gen_token_e/n · x1_emo · x1_neu · pre_token_e/n · pre_feat_e/n · xvec_e/n。
训练集 17 个说话人(0012–0014 缺 raw wav),train split 20,145 条。
2.2 训练
脚本 emo/exp/M12_tsm_dual/train_m12.py,每步流程:
1. 取 batch(8 条),对每条构造两支输入:
   情感支 = pre_token_e ⊕ gen_token_e,目标 pre_feat_e ⊕ x1_emo
   中性支 = pre_token_n ⊕ gen_token_n,目标 pre_feat_n ⊕ x1_neu   ← 双支各自 token
2. 每条采样一个共享 t ~ U[0.05, 0.95];生成段噪声 z_gen 两支共享,前缀段噪声各自独立
3. CFM 构造 y = (1−(1−σ)t)·z + t·x1,u = x1 − (1−σ)z,σ=1e-6
4. 批内 pad 到 Kmax,情感支、中性支各一次批量前向(DiT estimator)
5. 损失(定义见下;λ=0 臂的 L_ortho 仅记日志不进梯度)
6. AdamW 更新,grad_clip=1.0
损失与记号(均只在生成段上计算,\(v_e, v_n\) 为两支的 DiT 输出速度):
推理时 \(v = B + \alpha A\)。
其中 \(u = x_1 - (1-\sigma)z\) 为 CFM 目标速度;\(\hat{A}_i, \hat{B}_j\) 为 mel 第 \(i,j\) 通道 沿时间轴归一化后的行向量(80×80 全对内积)。
日志诊断量:A_share \(= \lVert A\rVert^2 / \lVert v_e\rVert^2\);
cos_A_B \(= \langle A, B\rangle / (\lVert A\rVert\,\lVert B\rVert)\)(整张张量展平后的余弦)。
| 参数 | 值 |
|---|---|
| 起点 | CosyVoice3 基座 flow.pt 的 estimator(不传 --ckpt) |
| 可训参数 | DiT estimator 331.14M(LLM / flow 其余 / hift 冻结) |
| 生成骨架 | 双支各自 token(完整双路,同 M12b / M13-λ0) |
| λ_ortho | {0, 0.1, 0.5, 1.0, 10} 五臂平行(卡 0–4;除 λ 外全同。λ=10 时 λ·L_ortho 与 L_FM 同量级,为正交项的强约束端点) |
| epochs / 步数 | 6 / ≈12,768(batch 8) |
| 样本见次数 | ≈102k(v4 = 107k,0.95×) |
| lr / 优化器 | 1e-5 / AdamW |
| grad_clip / seed | 1.0 / 1234 |
| 日志 | 每 100 步:loss、L_FM 两支、L_ortho、grad_norm、K、A_share、cos_A_B |
| 输出 | outputs/m14_l{0,01,05,10,100}/,每 epoch 存 ckpt |
2.3 推理与评测
推理脚本 emo/exp/M12_tsm_dual/infer_m12.py(--mode tok_resample --natural_prompt,同 M13-F2):
1. LLM 两遍:情感参考 → gen_token(N_e);中性参考 → tok_n(N_n);种子 seed / seed+100
2. 中性 token 最近邻重采样至 N_e
3. 两支各自构造 flow 输入(各自 prompt,自然音频,不做 TSM)
4. 生成段噪声共享,双轨 Euler 10 步,生成段速度按 v = (1−α)·v_neu + α·v_emo 混合
5. HiFT 声码
| 项 | 值 |
|---|---|
| 测试集 | p6_test_zh.jsonl(held-out 中文) |
| 规模 | 84 条/臂 × 5 臂(4 情感 × 3 句 × 7 α) |
| α 网格 | {0, 0.25, 0.5, 0.75, 1.0, 1.25, 1.5} |
| 指标 | emotion2vec delta / 受控数 / 负向数 · CER(paraformer) · SECS(campplus) · UTMOS(含 α=0 单列) |
| 探针 | M5 A-结构探针(36 测量/ckpt):有效秩、A_share、帧间 cos、情感专一性 gap;跑 λ=0、λ=1.0、λ=10 三 ckpt |
| 主对照 | v4(同起点同预算);次对照 M13 同 λ 臂(同法、v4 起点);λ 臂间互为对照 |
3 资源
训练 5 臂并行(卡 0–4)约 2.5 小时;推理 + 评测 5 臂并行(卡 0–4)约 30 分钟;探针 3 卡(卡 5–7)约 20 分钟。
4 结果
🎧 M14 音频全量对照(6 臂 × 504 条,λ 臂间唯一变量是 λ_ortho)
4.1 主表(P6 held-out 中文,84 条/臂)
| 臂 | delta | 受控 | 负向 | CER | SECS | MOS | MOS@α=0 |
|---|---|---|---|---|---|---|---|
| v4(旧法,共享路推理) | 0.454 | 6/12 | 1 | 0.043 | 0.724 | 2.95 | 3.74 |
| M13-λ0(同法,v4 起点) | 0.572 | 7/12 | 0 | 0.098 | 0.580 | 2.73 | 3.59 |
| M14-λ0 | 0.733 | 9/12 | 0 | 0.107 | 0.573 | 2.75 | 3.69 |
| M14-λ0.1 | 0.642 | 8/12 | 0 | 0.089 | 0.581 | 2.78 | 3.66 |
| M14-λ0.5 | 0.585 | 7/12 | 0 | 0.114 | 0.581 | 2.77 | 3.68 |
| M14-λ1.0 | 0.668 | 8/12 | 0 | 0.114 | 0.565 | 2.82 | 3.82 |
| M14-λ10 | 0.667 | 8/12 | 0 | 0.108 | 0.577 | 2.78 | 3.68 |
4.2 训练曲线
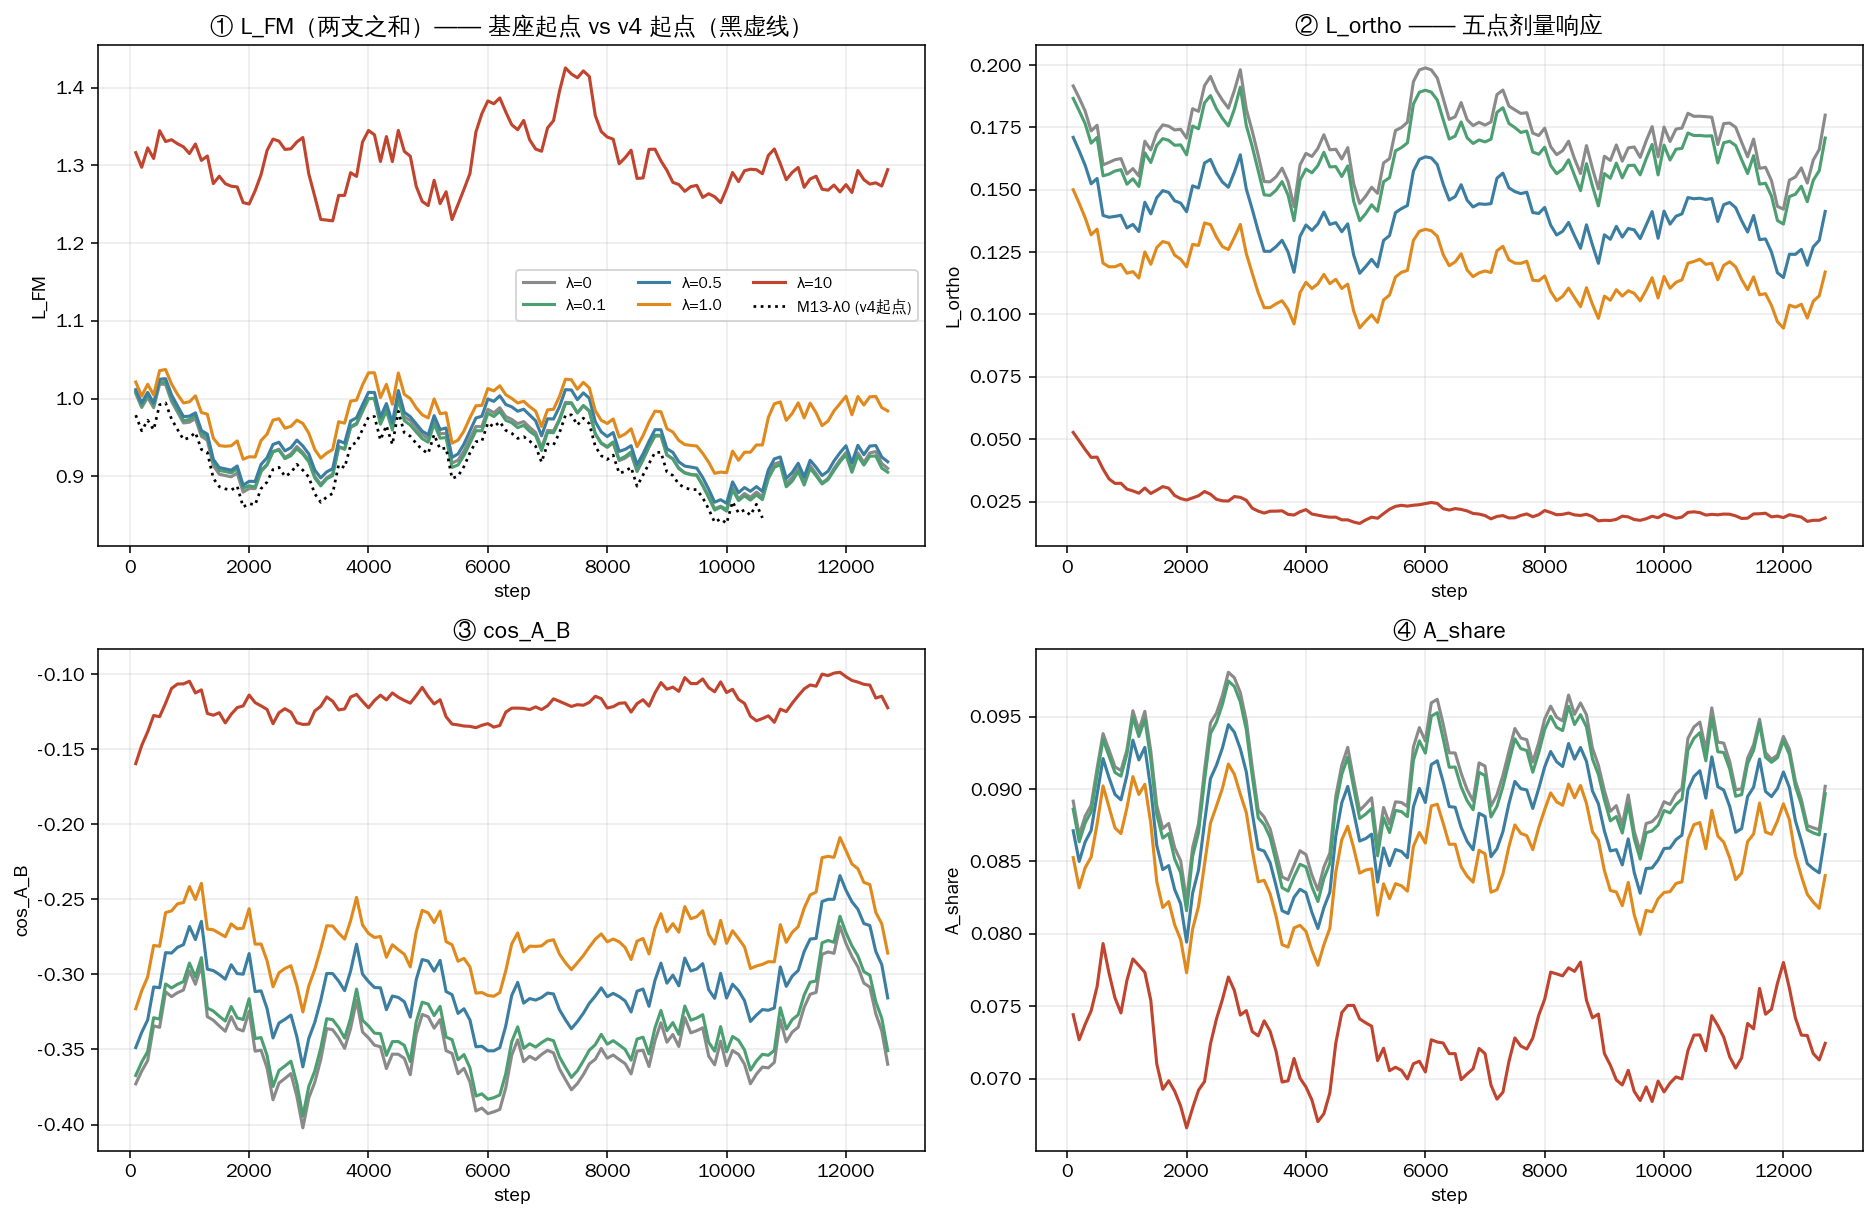
(图 ① 黑虚线为 M13-λ0(v4 起点)参照;v4 本身的日志为旧管线格式,未入图。)
训练侧末 50 点:
| λ | L_fm_emo | L_fm_neu | L_ortho(首5→末50) | A_share | cos_A_B |
|---|---|---|---|---|---|
| 0 | 0.4550 | 0.4511 | 0.1916 → 0.1661 | 0.0914 | −0.337 |
| 0.1 | 0.4539 | 0.4504 | 0.1866 → 0.1588 | 0.0909 | −0.329 |
| 0.5 | 0.4595 | 0.4554 | 0.1710 → 0.1340 | 0.0884 | −0.297 |
| 1.0 | 0.4831 | 0.4779 | 0.1500 → 0.1096 | 0.0855 | −0.265 |
| 10 | 0.6671 | 0.6193 | 0.0527 → 0.0191 | 0.0731 | −0.114 |
4.3 λ 臂间配对(各臂 vs λ=0,12 组逐组)
| λ=0.1 | λ=0.5 | λ=1.0 | λ=10 | |
|---|---|---|---|---|
| Δdelta ± SE | −0.091 ± 0.064 | −0.148 ± 0.100 | −0.065 ± 0.081 | −0.066 ± 0.064 |
| 显著性 | 1.41σ | 1.49σ | 0.80σ | 1.03σ |
全部 <2σ,点估计全为负。
4.4 探针(36 测量/ckpt)
| ckpt | rank_A | ‖A‖/‖v_emo‖ | 帧间 cos_A | 专一性 gap |
|---|---|---|---|---|
| m13_l0(v4 起点参照) | 34.44 | 0.066 | 0.235 | −0.030 |
| m14_l0 | 34.29 | 0.064 | 0.188 | −0.022 |
| m14_l10(λ=1.0) | 34.74 | 0.072 | 0.173 | −0.013 |
| m14_l100(λ=10) | 32.46 | 0.049 | 0.228 | −0.054 |
4.5 追加:A 的分布与真值残差对照(2026-08-28,用户提出)
问题:① A 的逐元素分布长什么样,A_share 偏小是否本身就是问题;
② \(\cos(A,\ x_1^{emo}-x_1^{neu})\) —— A 学到的是情感残差还是退化成了别的。
方法:M14-λ0 ckpt,held-out test split 300 条,teacher-forced 条件(与训练同构,
共享 \(t\) 与生成段噪声,此时目标之差恰为 \(u_e-u_n = x_1^{emo}-x_1^{neu}\),与 \(t,z\) 无关)。
脚本 emo/exp/M12_tsm_dual/probe_A_vs_gt.py。
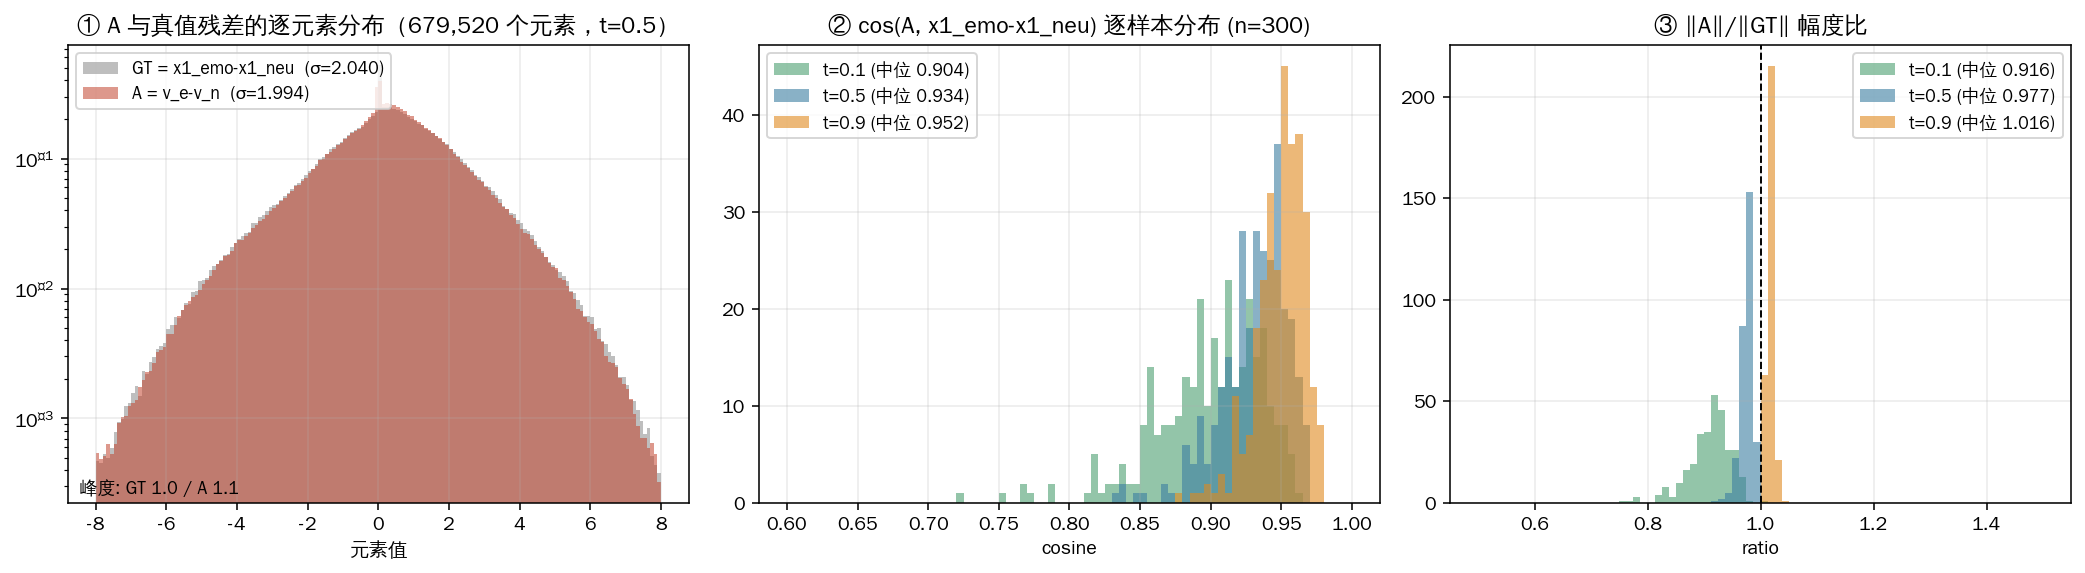
| \(t\) | cos(A, GT) 中位 [p10, p90] | ‖A‖/‖GT‖ 中位 | A_share | GT_share |
|---|---|---|---|---|
| 0.1 | 0.904 [0.854, 0.942] | 0.916 | 0.0788 | 0.0952 |
| 0.5 | 0.934 [0.898, 0.958] | 0.977 | 0.0894 | 0.0952 |
| 0.9 | 0.952 [0.927, 0.967] | 1.016 | 0.0971 | 0.0952 |
逐元素(t=0.5,679,520 个元素):A 与 GT 的分布几乎重合 (σ 1.994 vs 2.040,p1/p99 ±5.0 vs ±5.1,峰度 1.1 vs 1.0)。
读数:
- A 没有退化:与真值残差的余弦中位 0.90–0.95,幅度比 0.92–1.02(无收缩)—— 模型对「情感版与中性版 mel 之差」的估计在方向和幅度上都忠实
A_share偏小不是模型的问题:模型 0.079–0.097 vs 真值 0.0952 —— 数据里的情感残差本来就只占 mel 能量的 ~9.5%,A_share 只是如实反映了它- 随 \(t\) 增大(更接近干净 mel)估计变准(cos 0.904→0.952),符合 CFM 的常规行为
推论:α 控制的输入信号(A)是学对了的;此前各实验中控制效果的不稳定 应归因于 A 之后的环节(α 外推、评测口径 G1),而非 A 本身。
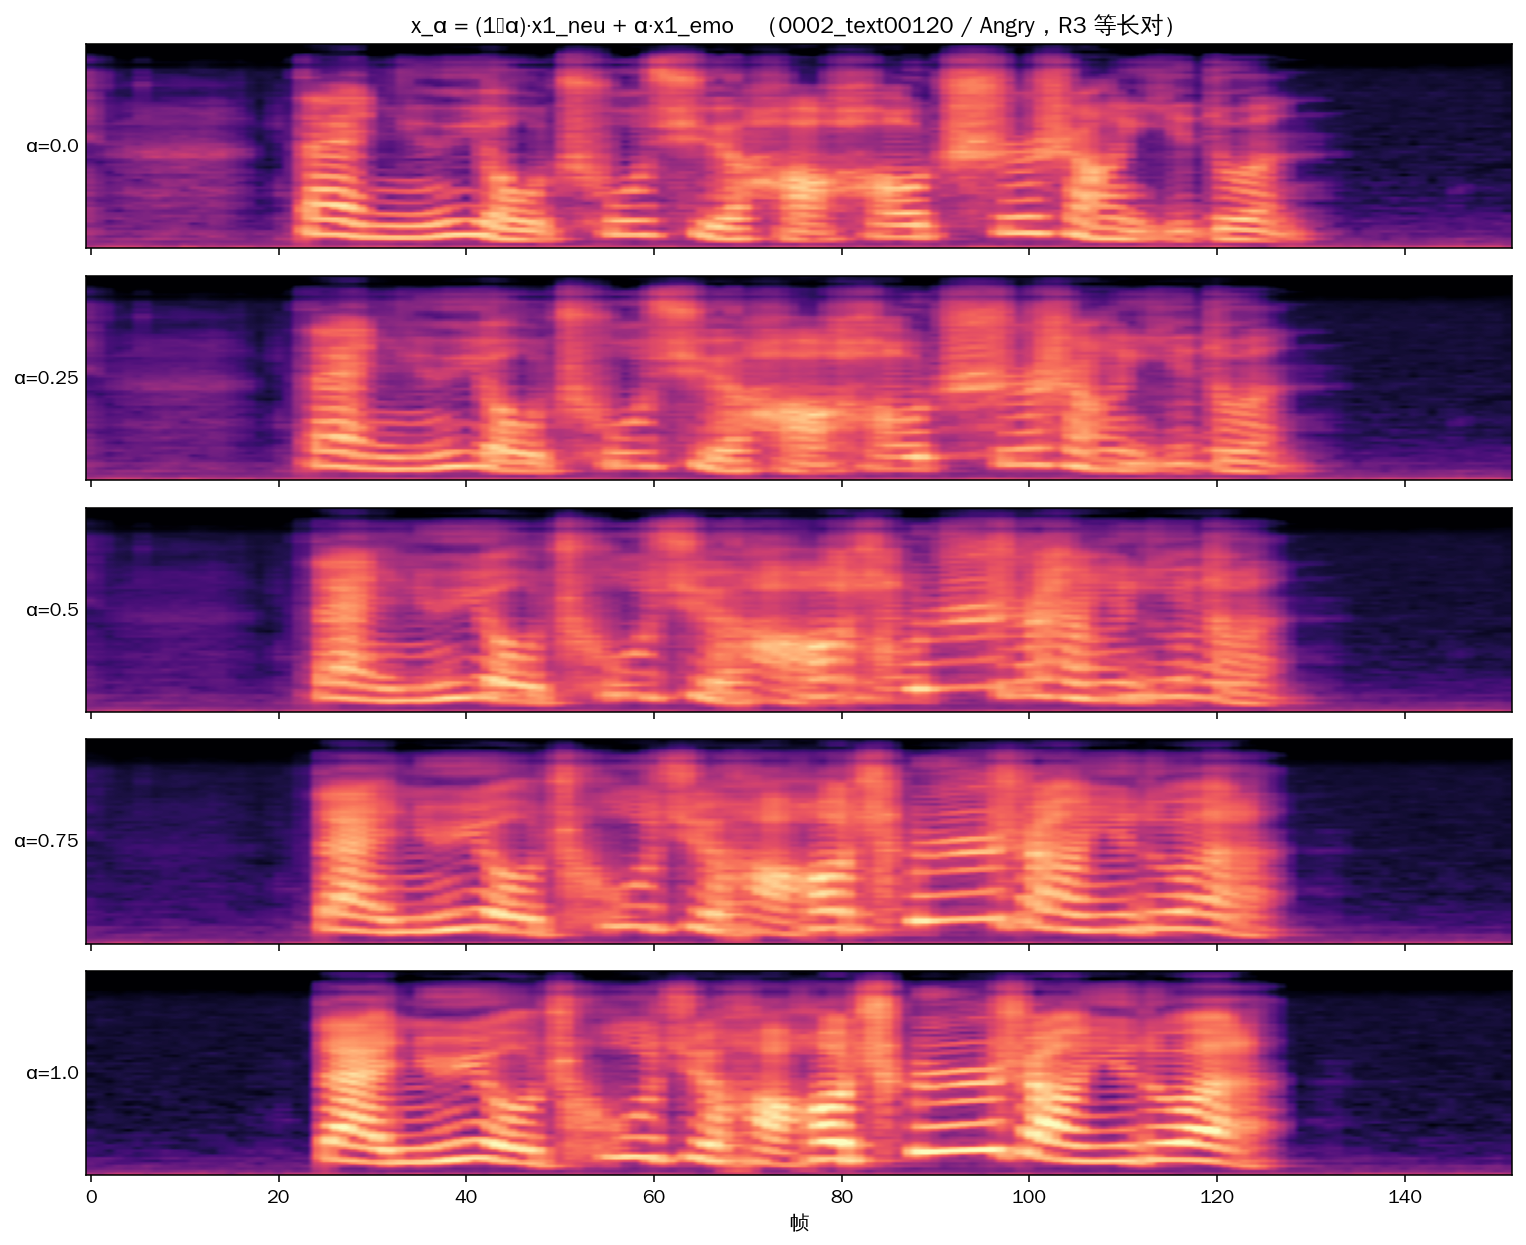
4.6 追加:理想插值目标 \(x_\alpha\) 直接声码(2026-08-28,用户提出)
共享 \(z\) 的直线 CFM 下,\(u_\alpha=(1-\alpha)u_n+\alpha u_e\) 的积分终点就是
\(x_\alpha=(1-\alpha)\,x_1^{neu}+\alpha\,x_1^{emo}\)。
本节把 \(x_\alpha\) 绕过模型直接送 HiFT 声码——这是 α 机制在"模型完美"时的理论输出上限。
样本 = 11 个评测组的 R3 等长对(0002_text00120/Sad 被 40% 形变过滤剔除,缺);
α ∈ {0, 0.25, 0.5, 0.75, 1},两端点即 TSM 中性 mel / 原始情感 mel 的声码结果。
| 组 | α=0(中性端) | α=0.25 | α=0.5 | α=0.75 | α=1(情感端) |
|---|---|---|---|---|---|
0001_text00010/Happy「不是,他住在沃斯盾的老房子里。」 |
|||||
0001_text00020/Happy「也许反倒是件好事」 |
|||||
0010_text00310/Happy「裁判全给了满分。」 |
|||||
0002_text00020/Angry「也许反倒是件好事」 |
|||||
0002_text00120/Angry「带女友出去好好吃上一顿。」 |
|||||
0002_text00150/Angry「我们休息一下喝杯咖啡。」 |
|||||
0001_text00290/Sad「真想不到,游泳竟有如此多的好处,」 |
|||||
0009_text00160/Sad「我们休息一下喝杯咖啡。」 |
|||||
0001_text00230/Surprise「我非常支持人们走进太空。」 |
|||||
0008_text00230/Surprise「我知道人生并不总是一帆风顺,」 |
|||||
0009_text00200/Surprise「我支持你。它是需要重做。」 |
脚本 emo/exp/M12_tsm_dual/interp_gt.py,wav 在 outputs/m14_interp/。
4.7 追加:共用 LLM token 的推理探针(2026-08-28,用户提出)
问题:双路效果不佳是否因为两支 LLM token 不一致,导致速度场无法直接加减。
设置:M14-λ0 ckpt,单组样本 0002_text00150/Angry(own 双路下 delta=0 的失败组),
自然 prompt,三种 token 策略同种子对拍:
- own 双路(现行 F 臂配置):情感支用情感 LLM 的 token(58 个),中性支用中性 LLM 的 token 重采样
- 共用情感 token:两支都用情感 LLM 的 58 token(= v4 式推理)
- 共用中性 token:两支都用中性 LLM 的 96 token(时长 2.32s → 3.84s)
| \(\alpha\) | own 双路 | 共用情感 token | 共用中性 token |
|---|---|---|---|
| 0.00 | emo/MOS 0.000/4.08 |
0.000/3.13 |
0.000/4.30 |
| 0.25 | emo/MOS 0.000/2.88 |
0.007/2.97 |
0.000/4.23 |
| 0.50 | emo/MOS 0.215/1.30 |
0.000/3.06 |
0.000/4.37 |
| 0.75 | emo/MOS 0.017/1.68 |
0.000/3.03 |
0.000/4.31 |
| 1.00 | emo/MOS 0.000/2.84 |
0.000/2.84 |
0.000/4.29 |
| 1.25 | emo/MOS 0.000/2.75 |
0.000/2.86 |
0.000/4.22 |
| 1.50 | emo/MOS 0.000/3.09 |
0.000/2.77 |
0.000/4.12 |
| own 双路 | 共用情感 tok | 共用中性 tok | |
|---|---|---|---|
| delta | +0.000 | +0.000 | +0.000 |
| MOS 均值 | 2.66 | 2.95 | 4.26 |
| MOS 中段谷(α=0.5/0.75) | 1.30 / 1.68 | 3.06 / 3.03 | 4.37 / 4.31 |
事实读数(n=1 组,emo 分类器口径受 G1 限制,听感以音频为准):
- 中段 α 的音质塌陷只出现在 own 双路(4.08→1.30→2.84 的 V 形); 两种共用 token 的变体都无谷——token 不一致确实是中段音质崩溃的原因
- 共用中性 token 全程 MOS 4.1–4.4,显著高于共用情感 token(2.8–3.1)
- 三种策略的 emo 分类器读数在该组全部为 0——token 策略未改变该组的情感判定
脚本:infer_m12.py --mode shared_emo / shared_neu,wav 在 outputs/m14_probe_sharedtok/。
5 结论
| 项 | 结论 |
|---|---|
| 基座起点 | ✅ 成立且不弱于 v4 起点(delta 0.733 vs 0.572、受控 9/12 vs 7/12)。M10–M13 的「vs v4」比较虽带起点混淆,方向未因此翻转 |
| α=0 音质 | ✅ 五臂 3.66–3.82,达到 v4 的 3.74 水平;「合成目标税」在从零训练下不再可见 |
| λ(正交) | ⚪ 终局零结果。λ 跨 0→10:正交性可以被压到近乎完美(L_ortho 0.019、cos_A_B −0.114、L_FM 代价 +42%),情感可控性全程无显著变化(<2σ,点估计还全为负)。至此四条辩解路径全部排除:对象错(M10)→ 剂量不足(M11a)→ 定义域错(M13)→ 未从头参与训练(本轮)。P4 终局 |
| 探针 | 专一性 gap 三 ckpt 全为负——A 的方向由句子主导这一结论(F6)在从零训练下第五次成立 |
| 遗留 | 双路 CER(0.09–0.11 vs 共享路 0.043)仍未归因;delta/受控数波动仍受 G1 口径限制 |