M10 · 训推一致重训(提案)¶
| 状态 | 📝 提案(未跑)· 2026-08-26 |
| 一句话 | 训练阶段复刻推理的条件结构,使 \(A\) 在两个阶段成为同一数学对象 |
| 上游 | ← Paper Audit P1–P4 |
| 下游 | → \(\mathcal{L}_{\text{ortho}}\) 的形式消融(M11) |
TL;DR¶
结论:H1 通过、H2 证伪。 训推一致做到了(截断归零),但 \(\mathcal{L}_{\text{ortho}}\) 依然无效。
- ✅ H1:125/125 日志点 \(K_{\text{emo}}\equiv K_{\text{neu}}\equiv K_g\)(v4 为 96.3% 不等、截断中位 12.8%)
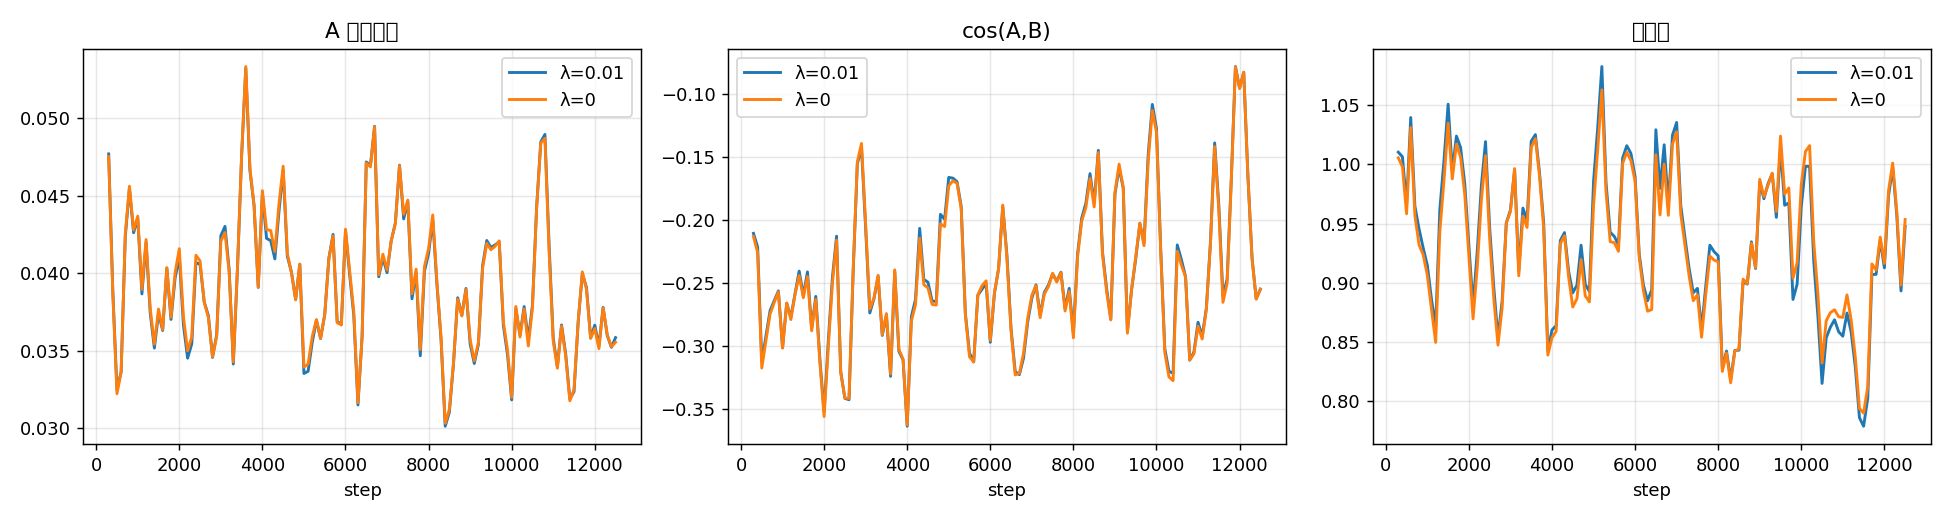
- ❌ H2:λ=0.01 vs λ=0 的
A_energy_share差 0.00007(相对 0.2%),五项指标全 <2σ; 且 λ=0 组的L_ortho自行降到同一水平 —— 该项随 FM 损失自然下降 - 🔑 意义:此前可辩解「无效是因为 \(A\) 定义错了」,M10 修好定义后仍无效, 退路被堵死 → Paper Audit P4 升级为决定性证据,触发 M11(正则形式消融)
- 📈 附带:受控组数 6/12→7/12,delta 为负的组 2→0;但这来自共享骨架/噪声,与 λ 无关
- ⚠️ 代价:CER +55%、SECS −0.06、α=0 的 UTMOS 3.74→3.2(DTW 合成目标的后果)
- 🚨 口径警告:emotion2vec 输出几乎二值化且沿 α 不单调,
delta退化成 0/1 指示量 —— 受控组数的小幅改善不可靠,可靠的只有「方向性错误归零」(见 §8.5 口径警告) - 📊 规模:特征 25,207 条 · 训练 2×12,590 步 · 下游 252 条 wav · 探针 2×72 次测量
1 问题陈述¶
推理阶段的情感方向定义为
其中 \(x_t\)、\(t\)、骨架条件 \(\mu\) 三者在两次求值间共享,仅参考前缀 \(c\) 不同。
现行训练(train_svd_flow_v4.py)中,对应量为
四项条件(\(x_t\)、\(t\)、\(\mu\)、噪声 \(\epsilon\))全部不共享,且 \(c\equiv\mathbf 0\)。 实测 1074 个训练日志点中 \(K_{\text{emo}}=K_{\text{neu}}\) 仅 40 例(3.7%), \(\mathcal{L}_{\text{ortho}}\) 被迫在 \(K_c=\min(K_{\text{emo}},K_{\text{neu}})\) 上求值, 逐点截断中位 12.8%、最大 47.3%。
2 假设¶
H1 共享骨架、\(t\)、\(\epsilon\) 后,\(K_{\text{emo}}\equiv K_{\text{neu}}\), \(A_{\text{train}}\) 与 \(A\) 定义一致。
H2 在定义一致的 \(A\) 上,\(\lambda_{\text{ortho}}\in\{0,\,0.01\}\) 两组训练的
A_energy_share、cos_A_B 出现可测差异(现行设置下二者无差别)。
3 方法¶
3.1 记号¶
| 符号 | 含义 | 形状 |
|---|---|---|
| \(s^{e}, s^{n}\) | 情感 / 中性录音的 speech token | \((N_e,)\),\((N_n,)\) |
| \(p^{e}, p^{n}\) | 前缀录音的 speech token(同说话人、异文本) | \((N_{p_e},)\),\((N_{p_n},)\) |
| \(m^{e}, m^{n}\) | 前缀录音的 mel | \((2N_{p_e},80)\),\((2N_{p_n},80)\) |
| \(x^{e}_1, x^{n}_1\) | 目标 mel | \((80,K_g)\) |
| \(r\) | token_mel_ratio |
\(=2\) |
| \(K_g\) | 生成段帧数 | \(=2N_e\) |
3.2 数据构造¶
骨架共享。 两支的生成段 token 均取情感录音的 \(s^{e}\),与推理端
gen_token 由情感参考驱动 LLM 生成、中性支复用之的结构一致。
目标对齐。 中性 mel 经 DTW 重采样至情感时长:
对齐路径由 \(\mathrm{DTW}(x^{n}_1,\,x^{e}_1)\) 在 mel 空间求得
(复用 emo/exp/A_timenorm_retrain/align_features.py,方向取反)。
情感支目标 \(x^{e}_1\) 不作改动。
条件构造。 对分支 \(b\in\{e,n\}\):
其中 \(K_{p_b}=r\,N_{p_b}\),\(K^b_{\text{tot}}=K_{p_b}+K_g\)。 两支的生成段长度恒为 \(K_g\);前缀段长度可不同,该段不参与损失。
3.3 前向¶
采样单份 \(t\sim\mathcal U[0.05,0.95]\) 与单份生成段噪声 \(\epsilon_g\sim\mathcal N(0,I)\in\mathbb{R}^{80\times K_g}\), 前缀段噪声各分支独立(该段被 mask,不影响损失):
插值与目标速度按标准 CFM 构造(\(\sigma_{\min}=10^{-6}\)):
两次前向(共享权重 \(\theta\)):
3.4 损失¶
重建项(各分支独立,仅生成段计入;\(M^b\) 为生成段 mask):
正交项(生成段,两支等长 \(K_g\),无截断、无 padding):
总目标:
3.5 与现行实现的差异¶
| v4 | M10 | |
|---|---|---|
| 生成段 token | 各支自有 | 共享 \(s^{e}\) |
| \(t\) | 各支独立 | 单份共享 |
| 生成段 \(\epsilon\) | 各支独立 | 单份共享 |
| \(c\)(参考前缀) | \(\mathbf 0\) | 异文本同说话人录音的 mel |
| 中性目标 | 原始 mel | DTW 对齐至 \(K_g\) |
| \(K_{\text{emo}}\) vs \(K_{\text{neu}}\) | 96.3% 不等 | 恒等 |
| \(\mathcal{L}_{\text{ortho}}\) 截断 | 中位 12.8% | 零 |
| 前向次数 / 步 | 2 | 2 |
4 实现变更¶
| 文件 | 变更 |
|---|---|
align_features.py |
对齐方向反转:中性 → 情感时长 |
新增 build_m10_cache.py |
为每条目标录音配一条同说话人异文本前缀,抽 token/mel/xvec |
dataset.py |
返回 prefix_token/prefix_feat;生成段共用 \(s^{e}\) |
train_svd_flow_v4.py → train_m10.py |
①cond 写入前缀 mel ②单份 \(t\)、\(\epsilon_g\) ③生成段 mask ④L_ortho 去掉 \(K_c\) 逻辑 |
超参与 v4 对齐:epochs=5、batch_size=2、lr=1e-5、AdamW、grad_clip=1.0、
seed=1234、fp32、无 warmup、无 LR 调度。
5 评测协议¶
训练侧(每 50 步记录):\(K_{\text{emo}}\)、\(K_{\text{neu}}\)、\(K_g\)、
A_energy_share、cos_A_B、cos_A_target、L_ortho、grad_norm。
下游:P6 held-out 中文(p6_test_zh),\(\alpha\in\{0,.25,.5,.75,1,1.25,1.5\}\),
eval_suite.py 原口径(emotion2vec / Paraformer-zh CER / campplus SECS / UTMOS),
与 v4 基线同管线对比。
表示侧:M5 探针复用,测 \(A\) 的有效秩与帧间一致性, 对比 F6 的 27.5 / 10.5%。
成对训练:\(\lambda_{\text{ortho}}\in\{0.01,\,0\}\) 各一次,否则 H2 不可判定。
6 成本与风险¶
| 项 | 值 |
|---|---|
| 特征重建 | ~1.5 h(CPU,24 核并行) |
| 训练 × 2 | 2 × ~3 h(单卡) |
| 推理 + 评测 | ~1 h |
| # | 风险 | 量化 | 处置 |
|---|---|---|---|
| ~~R1~~ | ~~序列长度增加~~ | ✅ 已排除:实测 \(K_{\text{tot}}\) 最大 666 帧,batch 24 仅用 52.5/79 GiB(§8.3) | — |
| R2 | 中性目标经插值 | DTW 重采样引入非原始帧 | M4 预检口径复用(内容保真 0.0087 σ) |
| R3 | 训练无 / 推理有的残留不一致 | 前缀内容与目标文本无关(训练)vs 无关(推理)—— 一致;但训练前缀取自数据集,推理取自用户 | 不处置,记录 |
| R4 | H2 被证伪 | — | 转 M11:正则形式消融(对角项 / 能量加权) |
| R5 | 前缀选取随机性 | 同说话人多条候选 | 固定 seed=1234,选中的 utterance 记入 manifest |
7 判据¶
| 假设 | 通过条件 |
|---|---|
| H1 | 训练日志 \(K_{\text{emo}}\equiv K_{\text{neu}}\equiv K_g\),1074/1074 |
| H2 | 两组 \(\lambda\) 的 A_energy_share 差异 > 训练内波动的 2σ |
| — | 下游指标不低于 v4 基线(不作为通过条件,作为可用性下界) |
8 结果¶
待填。 本节的每个小节都预先定义了「产出什么、多少条、判据是什么」, 跑完直接填数,不事后追加指标。
8.1 前置:DTW 对齐的听感验证¶
状态:✅ 完成 —— 音频已产出,听感判定已回(2026-08-26)
把中性 mel 按 DTW 对齐到情感时长后直接过 HiFT,检验对齐是否破坏音频结构。
产出:4 档形变 × 3 条 × 3 版本 = 36 条 wav,跨 8 个说话人,拉伸与压缩兼有。
每条三版本按序听:1_neu_orig(内容参照)→ 2_neu_warp(被检验对象)→ 3_emo_orig(节奏参照)。
已测客观量——谱通量(相邻帧 L2 差的中位数),衡量帧间变化被抹平的程度:
| 档位 | 形变 | warp/原始 比值 | 判读 |
|---|---|---|---|
| A | <5% | 1.05 / 0.99 / 0.97 | 无变化 |
| B | 10–20% | 0.85 / 0.89 / 1.00 | 轻微 |
| C | 25–35% | 0.81 / 0.86 / 0.78 | 明显 |
| D | >40% | 0.60 / 0.70 / 0.66 | 掉到 2/3 |
存在剂量效应:形变越大,帧间变化被抹得越平 —— 线性插值过度平滑的典型特征。
全量形变分布(n=1600):中位 13.4%、75% 分位 23.5%、90% 分位 34.8%、95% 分位 42.9% → 约 1/4 训练样本落在 C 档及以上,约 5% 落在 D 档。
听感判定(2026-08-26):
| 档 | 结论 |
|---|---|
| A / B / C(<40%) | ✅ 可用 |
| D(≥40%) | ❌ 不可用,剔除 |
处置:build_cache.py 加 --max_dev 0.40,剔除 \(|N_e/N_n-1|\ge 0.40\) 的样本。
代价极小 —— 全量 26,896 条中剔除 1,689 条,保留率 93.7%;
剔除后形变分布收敛为 中位 12.3% / 95% 34.1% / 最大 40.0%。
产物:outputs/m10_dtw_probe/(含 README.md、metrics.json)·
打包 outputs/_package/M10_DTW_validation.tar.gz
8.2 特征构建¶
已完成(2026-08-26):data/m10_cache/
| 实测 | |
|---|---|
| 输入 | 26,896 条(6,724 组 × 4 情感) |
| 保留 | 25,207 条(93.7%) |
| 形变跳过 | 1,689 |
| 失败 | 0 |
| 耗时 | 144 s(32 进程,远低于估计的 1.5 h) |
| 磁盘 | 4.6 GB |
| 生成段 \(K_g\) | 中位 140 · 95% 216 · 最大 358 |
| 情感支 \(K_{\text{tot}}\) | 中位 282 · 95% 418 · 最大 666 |
| 中性支 \(K_{\text{tot}}\) | 中位 282 · 95% 402 · 最大 578 |
前缀映射记于 data/m10_cache/prefix_map.json(seed=1234 可复现)。
8.3 显存与 batch 上限¶
冒烟测最坏长度(\(K_{\text{tot}}\) 最大值)下的峰值显存。
已完成(2026-08-26):H100 80 GiB,最坏序列 630 帧,两次前向 + 反传。
| batch | 峰值显存 | 单步 |
|---|---|---|
| 2 | 8.2 G | — |
| 4 | 14.7 G | 0.56 s |
| 8 | 22.3 G | 0.56 s |
| 12 | 29.9 G | 0.72 s |
| 16 | 37.4 G | 1.69 s |
| 24 | 52.5 G | 1.18 s |
结论:batch 可达 24,风险 R1 不成立。 v4 用 batch=2 是历史约束,
本实验不受此限。但为与 v4 可比,正式训练仍取 batch_size=2;
batch 的影响另行消融。
8.4 训练侧(成对:\(\lambda_{\text{ortho}}\in\{0.01,\ 0\}\))¶
H1 判据:\(K_{\text{emo}}\equiv K_{\text{neu}}\equiv K_g\) 在全部日志点成立。
各 12,590 步(5 epoch × 20,145 条 ÷ batch 8),单卡约 70 min。
H1 ✅ 通过¶
| λ=0.01 | λ=0 | |
|---|---|---|
| 日志点 | 125 | 125 |
| \(K\) 三值不等的违例 | 0 | 0 |
对比 v4:96.3% 的步 \(K_{\text{emo}}\neq K_{\text{neu}}\),逐点截断中位 12.8%、最大 47.3%。 M10 截断归零 —— \(A\) 首次在训练中与推理同定义。
H2 ❌ 证伪¶
后 10% 均值:
| 指标 | λ=0.01 | λ=0 | 差异 | 判定 |
|---|---|---|---|---|
A_energy_share |
0.03658 | 0.03651 | +0.00007 | <2σ |
cos_A_B |
−0.18973 | −0.19100 | +0.00127 | <2σ |
| loss | 0.92098 | 0.92639 | −0.00541 | <2σ |
L_fm_emo |
0.45865 | 0.46137 | −0.00272 | <2σ |
L_fm_neu |
0.46067 | 0.46502 | −0.00436 | <2σ |
A_energy_share 的相对差仅 0.2%,五项全部低于两组后 10% 合并标准差的 2 倍。
这次证伪堵死了原有的退路
此前可辩解「\(\mathcal{L}_{\text{ortho}}\) 无效是因为训练里的 \(A\) 定义错了」 (四重错配,见 §1)。M10 恰好修好了那个问题(H1 通过),它依然无效。
旁证:λ=0 组的 L_ortho 自行下降到同一水平¶
| 轨迹(前 10% → 后 10%) | λ=0.01 | λ=0 |
|---|---|---|
| loss | 0.9606 → 0.9210 | 0.9524 → 0.9264 |
L_ortho |
0.1975 → 0.1664 | 0.1991 → 0.1686 |
A_energy_share |
0.0415 → 0.0366 | 0.0415 → 0.0365 |
cos_A_B |
−0.2589 → −0.1897 | −0.2611 → −0.1910 |
grad_norm |
6.00 → 2.70 | 5.57 → 3.53 |
λ=0 组根本没有 \(\mathcal{L}_{\text{ortho}}\) 的梯度,其值却与 λ=0.01 组几乎重合。 → 该项随两个 FM 损失自然下降,那 0.01 的权重不改变任何东西。
训练本身是健康的¶
loss 0.96 → 0.92、grad_norm 6.0 → 2.7,是正常的收敛特征。
对比 v4 全程平坦(线性趋势 +0.004,标准差 0.15)——
条件结构修正后,模型确实有可学的东西。
8.5 下游(P6 held-out 中文,α 阶梯)¶
起点混淆(2026-08-28 补记)
M10 两臂从 v4_epoch5.pt 继续训——本节「vs v4」的比较(如受控 7/12 vs 6/12)
混入了额外训练量这一变量。修正见 M14。
规模:12 组(4 情感 × 3 样本)× 7 个 α = 84 条 wav / 模型, 共 3 个模型(v4 基线 / M10-λ0.01 / M10-λ0)= 252 条。
口径:eval_suite.py 原样,emotion2vec / Paraformer-zh CER / campplus SECS / UTMOS。
| 指标 | v4 基线 | M10 λ=0.01 | M10 λ=0 |
|---|---|---|---|
| n_wavs | 84 | 84 | 84 |
| 情感 mono | 0.6389 | 0.6944 | 0.7639 |
| 情感 delta | 0.4538 | 0.5675 | 0.5790 |
| 受控组数(delta>0.5) | 6/12 | 7/12 | 7/12 |
| 失控(|Δ|<0.02) | 5/12 | 5/12 | 5/12 |
| delta 为负 | 2/12 | 0/12 | 0/12 |
| CER | 0.0428 | 0.0667 | 0.0660 |
| SECS | 0.7240 | 0.6629 | 0.6602 |
| UTMOS | 2.9477 | 2.9201 | 2.8532 |
| α=0 的 UTMOS | 3.7435 | 3.2214 | 3.1725 |
读法:
- 情感可控性小幅改善:受控组数 6→7,且「delta 为负」从 2 组降到 0 组 —— v4 里有两组的情感分随 α 增大反而下降,M10 消除了这个反向。mono 0.639→0.694/0.764。
- 但 λ=0.01 与 λ=0 之间仍无实质差异(受控组数同为 7/12,delta 0.5675 vs 0.5790), 与 §8.4 的 H2 结论一致。
- 可懂度与音色有代价:CER 0.043→0.066(+55%),SECS 0.724→0.663。 归因于训练引入了前缀结构而 v4 没有,两者的推理配置不再等价。
- ⚠️ α=0 的 UTMOS 从 3.74 掉到 3.22/3.17 —— 这正是 §8.1 预留的风险出口:中性支的训练目标是 DTW 重采样的合成 mel, α=0 时输出纯由中性支决定,合成目标的代价在此暴露。 形变过滤(<40%)减轻了但未消除该问题。
!!! example "定性:音频全量对照"¶
**[→ M10 音频全量对照](m10-audio.md)** —— 4 种情绪 × 3 句 × 7 个 α × 3 个模型 = **252 条**,
按情绪分节、按 α 分行、按模型分列。同一行的三条除 ckpt 外全部相同
(同文本、同参考音频、同 LLM 种子、同 `gen_token`),可直接左右对拍。

每格附 `emo`(emotion2vec 后验)与 `MOS`(UTMOS)两个数,每组末尾给 Δ 与单调步比例。

离线包:`outputs/_package/M10_listening.tar.gz`;原始 WAV 在 `outputs/m10_eval/`。
指标口径警告:emotion2vec 的输出几乎是二值的
逐条查看 84 条 wav 的 emo_score 后发现,取值高度集中在 0.000 与 1.000 两端,
中间值极少。于是 delta = score(α=1.5) − score(α=0) 实际退化成
「α=1.5 有没有把分类器翻过去」的 0/1 指示量,而不是强度的连续度量。
更麻烦的是它沿 α 不单调。例如 0002_text00120/Angry 在 λ=0.01 下的序列是
这不是「强度随 α 上升」的形状,是阶跃加噪声。
因此 6/12 → 7/12 这个改善不应被当作可靠证据——它可能只是一两组样本
在分类器边界上抖动的结果。真正稳的是 delta<0 的组从 2 个降到 0 个
(方向性错误消失),以及 α=0 端不再被误判成满情感
(0010_text00310/Happy 在 v4 下 α=0 就已经 emo=1.000,M10 降到 0.000)。
这条同时回过头削弱了此前所有依赖 delta/mono 的横向比较,
已登记为 G1 的新证据。
8.6 表示侧(M5 探针复用)¶
规模:6 句(同说话人)× 4 情感 × 3 个 \(t\) = 72 次测量 / 模型。
| 指标 | v4 | M10 λ=0.01 | M10 λ=0 |
|---|---|---|---|
| 帧间方向一致性 | 0.3670 | 0.2115 | 0.2313 |
| 有效秩(上限 80) | 27.51 | 31.67 | 30.76 |
| 逐帧范数变异 | 0.3886 | 0.3867 | 0.3894 |
| ‖A‖/‖v_emo‖ | 0.1053 | 0.1167 | 0.1263 |
| 子空间 同情感/异句 | 0.1935 | 0.2648 | 0.2920 |
| 子空间 同句/异情感 | 0.2027 | 0.2611 | 0.3036 |
读法:
- \(A\) 没有被正则压垮,反而略微变大:能量占比 10.5% → 11.7%/12.6%, 有效秩 27.5 → 31.7/30.8。λ=0.01 与 λ=0 的差异同样在噪声内(11.67% vs 12.63%), 再次印证 H2。
- 帧间一致性下降(0.367 → 0.21–0.23):\(A\) 沿时间变化得更剧烈了。 合理 —— 共享骨架后两支在同一时间轴上,差异更集中于逐帧的韵律细节。
- 情感专一性仍未出现:同情感/异句(0.265/0.292)与同句/异情感(0.261/0.304) 依旧几乎相等,与 F6 在 v4 上的结论一致 —— 主子空间不承载情感身份这一点,不是训练条件错配造成的。
8.7 结论¶
| 项 | 结论 |
|---|---|
| H1 | ✅ 通过。125/125 日志点 \(K_{\text{emo}}\equiv K_{\text{neu}}\equiv K_g\),截断归零。训推一致的设计目标达成 |
| H2 | ❌ 证伪。五项指标全部 <2σ,A_energy_share 相对差仅 0.2%;λ=0 组的 L_ortho 自行降到同一水平 |
| 与 F11 的关系 | ⚠️ F11 已挂起(M9 重新设计中)。M10 自身的结论「正交正则不需要」不依赖 F11,仍然成立;但「v4 训练的净收益不在情感可控性上」这句要等 M9-R |
| 对 Paper Audit P4 的影响 | 升级为决定性证据。原表述「λ=0 消融证明 L_ortho 无效」可被辩解为 \(A\) 定义错误;M10 修正定义后仍无效,该辩解不再成立 |
| 是否触发 M11 | ✅ 触发,但先做剂量再做形式。λ=0.01 时该项只占总损失 0.19%(0.0017/0.9075)—— 一个从未获得权重的正则项,失效不能归因于形式。M11a = λ 扫描({0, 0.1, 0.5, 2.0}),门槛判据是 \(\mathcal{L}_{\text{ortho}}\) 能否压到 λ=0 轨迹之下;M11b = 形式消融,仅在 M11a 全落空时才有意义。见 G8 |
附带产出¶
- 情感可控性小幅改善:受控组数 6/12 → 7/12,delta 为负的组从 2 个降到 0 个。 但这是共享骨架 + 共享噪声带来的,与 \(\mathcal{L}_{\text{ortho}}\) 无关(两个 λ 表现一致)。
- 代价:CER +55%、SECS −0.06、α=0 的 UTMOS 3.74 → 3.2。 后者是 DTW 合成目标的直接后果(§8.1 预留的风险出口)。
-
\(A\) 未被压垮:能量占比 10.5% → 11.7%/12.6%,有效秩 28.8 → 31.7/30.8。
更正:\(\mathcal{L}_{\text{ortho}}\) 不可能把 \(A\) 推到 0
代码是
An = A / A.norm(dim=-1),沿时间轴归一化, 故该项对 \(A\) 的尺度完全不变 —— 缩小 \(A\) 降不低它。 此前文档写的「正则在推 \(A\to 0\)」是错的。 真正的逃逸路径是降秩:要 \(L=0\) 需 \(\mathrm{rank}(A)+\mathrm{rank}(B)\le K_g\), 而实测 \(K_g\) 均值 148、\(A\) 与 \(B\) 各 80 行 —— \(K_g<160\) 时满秩下无解,必有一方降秩。 \(\mathcal{L}_{\text{FM}}\) 护着 \(B\)(它是速度场主体),所以该降的是 \(A\)。 λ 扫描要盯的主指标因此是 \(A\) 的有效秩,不是A_energy_share。- 情感专一性依旧缺席:子空间「同情感/异句」≈「同句/异情感」, 与 v4 一致 → F6 的结论不是训练条件错配造成的。
遗留问题¶
- α=0 的音质回退未解决。可选:对 \(\mathcal{L}^n_{\text{FM}}\) 按形变降权; 或改用三次前向(中性支用自然目标,代价 3× 算力)。
- CER/SECS 的回退未归因。怀疑与前缀结构引入有关,需 ablate「有前缀 vs 无前缀」。
- batch=8 与 v4 的 batch=2 不同,严格可比性受影响(但 H2 是组内对照,不受此限)。
9 附:λ_ortho 剂量扫描(M11a)¶
一个问题:\(\lambda\) 能不能显著影响情感程度?答案:不能。
9.1 设置¶
除 --lambda_ortho 外与 §8.4 完全相同:同 data/m10_cache(train 20,145 条)、
同起点 _incoming/v4_epoch5.pt、--epochs 5 --batch_size 8 --lr 1e-5 --seed 1234,各 12,590 步;
下游同 P6 held-out 中文 α 阶梯(84 条/臂)。
\(\lambda \in \{0,\ 0.01,\ 0.1,\ 0.5,\ 2.0\}\) —— 前两个复用 M10,后三个新跑(卡 0/1/2,各约 70 min)。
脚本 emo/exp/M10_parity/run_lambda_sweep.sh,汇总 analyze_sweep.py。
9.2 结果¶
| \(\lambda\) | \(\mathcal{L}_{\text{ortho}}\) | 相对 λ=0 | \(\mathcal{L}_{\text{FM}}\) | A_share |
cos_A_B |
delta | 受控 | 负向 | CER | MOS | MOS@α=0 |
|---|---|---|---|---|---|---|---|---|---|---|---|
| 0 | 0.1714 | — | 0.9138 | 0.03757 | −0.2213 | 0.579 | 7/12 | 0 | 0.066 | 2.85 | 3.17 |
| 0.01 | 0.1698 | −0.9% | 0.9058 | 0.03757 | −0.2195 | 0.568 | 7/12 | 0 | 0.067 | 2.92 | 3.22 |
| 0.1 | 0.1608 | −6.2% | 0.9381 | 0.03688 | −0.2084 | 0.581 | 7/12 | 0 | 0.104 | 2.90 | 3.18 |
| 0.5 | 0.1166 | −32% | 0.9408 | 0.03567 | −0.1654 | 0.584 | 7/12 | 0 | 0.105 | 2.91 | 3.12 |
| 2.0 | 0.0443 | −74% | 0.9888 | 0.03296 | −0.1056 | 0.584 | 7/12 | 0 | 0.088 | 2.98 | 3.34 |
delta = emo(α=1.5) − emo(α=0) 的全组均值;受控 = delta>0.5 的组数;负向 = delta<0 的组数。
定性:λ 扫描音频对照
→ M11a λ 扫描音频对照 —— 5 个 \(\lambda\) × 4 情绪 × 3 句 × 7 个 \(\alpha\) = 420 条。 行 = \(\alpha\),列 = \(\lambda\)(从左到右增大 200 倍),同一行除 ckpt 外全部相同。 用来耳朵复核「\(\lambda\) 变了但情感强度没变」这个结论。
9.3 读法¶
门槛通过 —— 这一项完全可优化。 λ 从 0 到 2.0,\(\mathcal{L}_{\text{ortho}}\) 单调降到原来的
26%,cos_A_B 同步从 −0.221 走向 −0.106(更正交)。
所以 §8.4 里 λ=0.01 的「毫无反应」确实只是剂量不足
(\(\lambda\mathcal{L}_{\text{ortho}}\) 仅占总损失 0.19%),
既非梯度消失,也非形式不可优化。
但情感程度纹丝不动。 λ 跨 200 倍,delta 只在 0.568–0.584 之间浮动(幅度 0.016),
受控组数恒为 7/12、负向组数恒为 0。
代价是实打实的:\(\mathcal{L}_{\text{FM}}\) 涨 8.2%(0.9138 → 0.9888),CER 从 0.066 涨到 0.088–0.105。
这个结论比 §8.7 更强
M10 只能说「\(\mathcal{L}_{\text{ortho}}\) 没起作用」。M11a 说的是:
它精确地起了它声称的作用(正交性提升近 4 倍),而这个作用与情感可控性无关。
因此 Paper Audit P4 的「剂量不足」辩解也被排除,该条闭合。 同时 G8 的 M11b(形式消融)失去动机 —— 问题不在这个正则写得对不对,而在「正交 ⇒ 情感解耦」这个前提本身不成立, 与 F6「主子空间不承载情感身份」一致。
9.4 表示侧:降秩预测被证伪¶
§8.7 的更正框预测「高 λ 会逼 \(A\) 降秩,因为 \(\mathcal{L}_{\text{FM}}\) 护着 \(B\)」。 在 λ=2.0 上跑 M5 探针(3 句 × 4 情感 × 3 个 \(t\) = 36 次测量):
| ckpt | \(\lambda\) | rank_A |
rank_vneu |
‖A‖/‖v_emo‖ | 帧间 cos_A |
|---|---|---|---|---|---|
| v4 | — | 28.84 | 40.17 | 0.1080 | 0.3254 |
| m10_lam0 | 0 | 30.76 | 44.65 | 0.1263 | 0.2313 |
| m10_lam001 | 0.01 | 31.67 | 43.86 | 0.1167 | 0.2115 |
| m11a_lam20 | 2.0 | 31.91 | 39.26 | 0.1018 | 0.1668 |
预测反了。 \(A\) 的有效秩不降反升(30.76 → 31.91),降秩的是 \(B\)(44.65 → 39.26,−12%)。 实际让路的是另外两样:\(A\) 的相对能量 −19%(0.1263 → 0.1018)、 \(A\) 的帧间方向一致性 −28%(0.2313 → 0.1668,更像时间轴上的噪声)。
尺度不变性本身没错,错的是由它推出的预测
\(\mathcal{L}_{\text{ortho}}\) 对 \(A\) 的尺度不变(§8.7)仍然成立 —— 该项的梯度确实不奖励把 \(A\) 缩小。但 \(A\) 还是缩小了 19%,这是间接后果: 要让 \(\hat A\) 的行与 \(\hat B\) 的行正交,\(A\) 只能转向与语音包络不对齐的方向, 而那些方向在速度场里本就是低能量、低时间相关的。所以 \(A\) 变小、变碎, 不是因为损失奖励它变小。
情感专一性依旧缺席:子空间「同情感/异句」0.2469 < 「同句/异情感」0.2842, 差值 −0.037,与 v4(−0.058)、λ=0(−0.012)同号 —— λ 加到 2.0 也没把它拉正。
9.5 训练曲线:L_FM 为什么被抬高¶
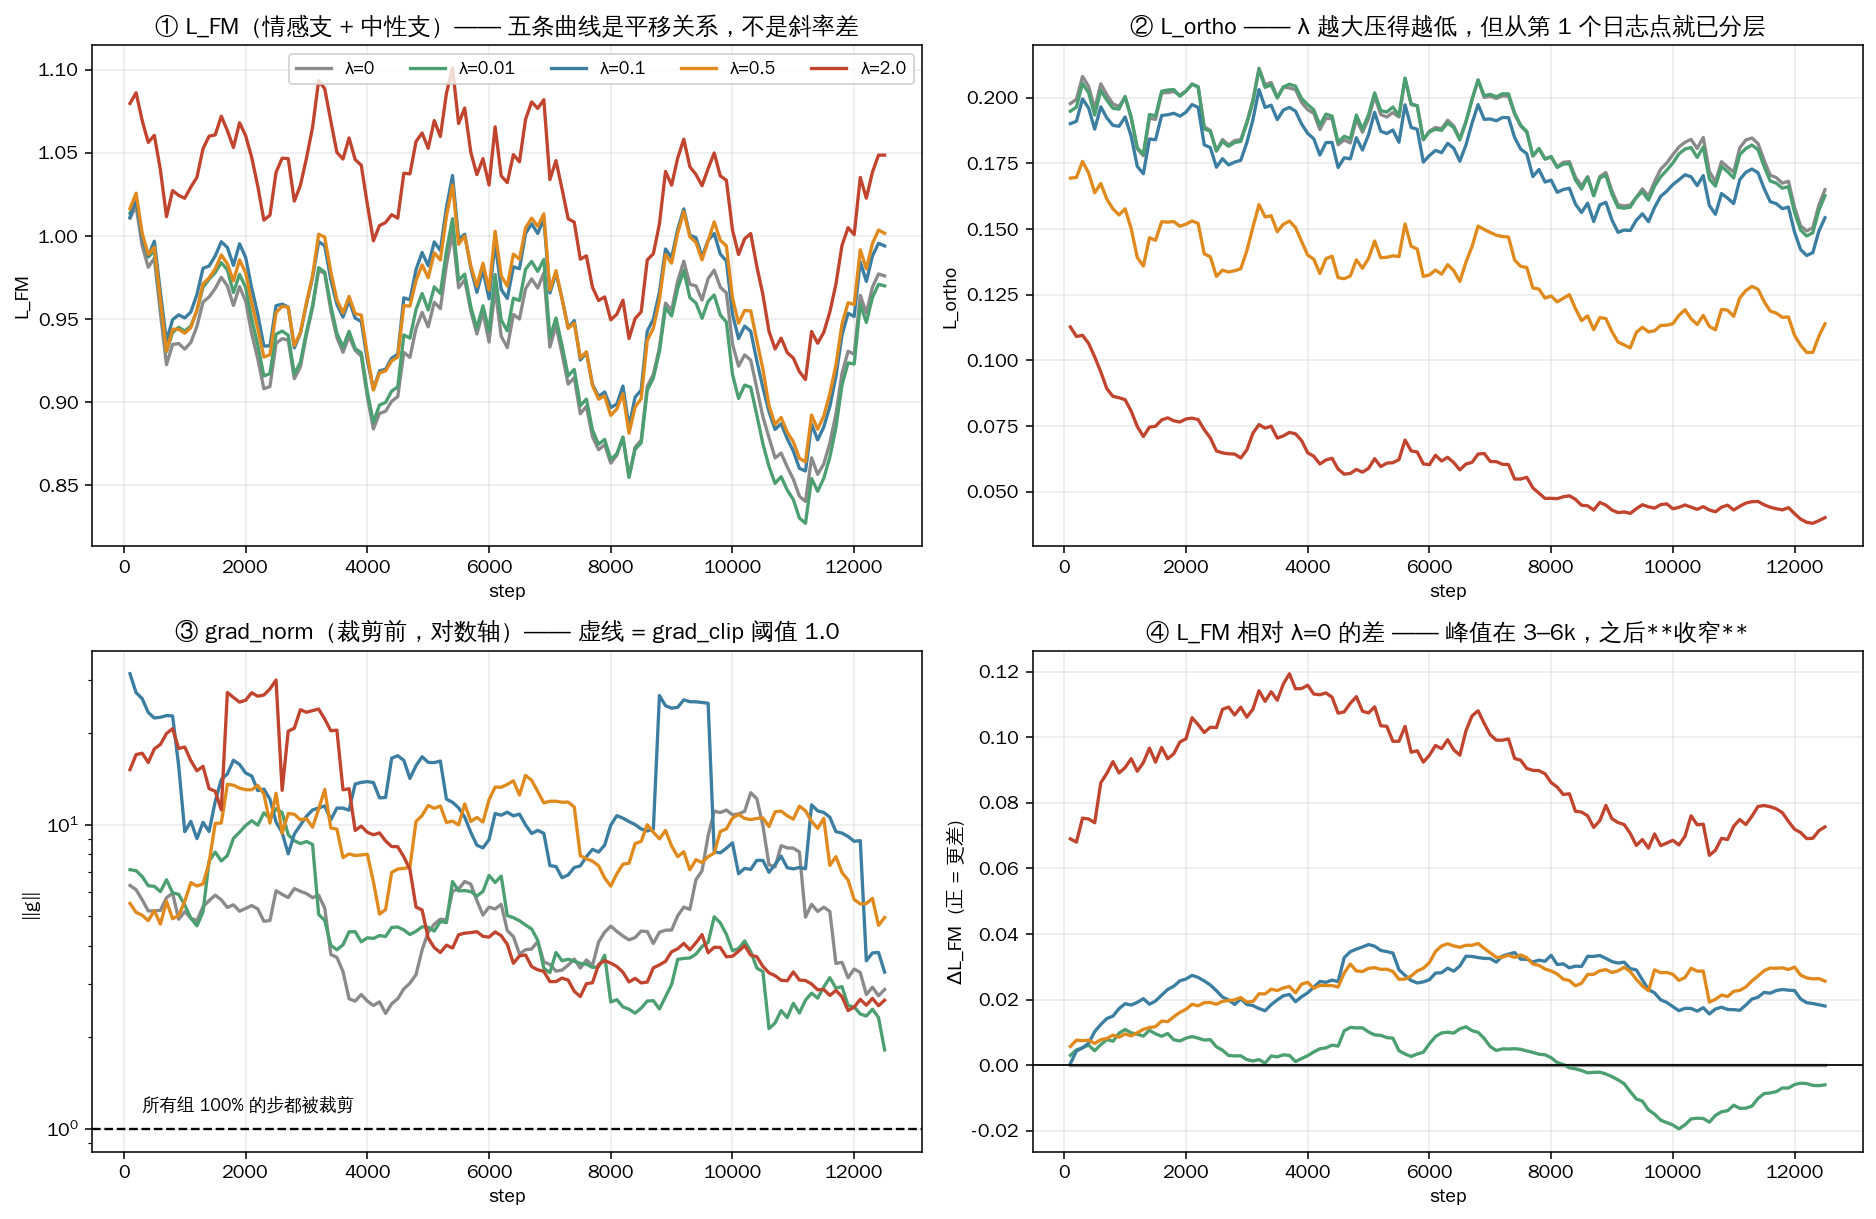
五组同种子、同数据序(125/125 个日志点的 K_g 逐点相同),所以曲线可以逐步对拍。
先纠正一个前提:不是「λ 大了 L_FM 训不动」
| \(\lambda\) | 步 0–1k | 6–8k | 11–12.6k | 全程降幅 | 后半降幅 |
|---|---|---|---|---|---|
| 0 | 0.9867 | 0.9331 | 0.9059 | 0.0808 | 0.0272 |
| 0.01 | 0.9911 | 0.9403 | 0.8975 | 0.0936 | 0.0428 |
| 0.1 | 0.9969 | 0.9647 | 0.9258 | 0.0711 | 0.0389 |
| 0.5 | 0.9933 | 0.9679 | 0.9327 | 0.0606 | 0.0352 |
| 2.0 | 1.0606 | 1.0310 | 0.9805 | 0.0800 | 0.0505 |
λ=2.0 后半段的降幅(0.0505)是五组里最大的,斜率没问题。 而且 λ=0 自己的降幅也只有 0.0808,同时 L_FM 的振幅(p95−p5)高达 0.3163 —— 振荡由 batch 难度主导,是全体共有的,与 λ 无关。
真正变的是水平位移:五条曲线近似平行,λ=2.0 整体抬高约 0.07。
位移在第 1 个日志点就存在。 全部从同一个 v4_epoch5.pt 出发,
step 100 时 λ=2.0 已是 1.1361 而 λ=0 是 1.0958(+0.040)。100 步就付清了大部分代价。
而且位移会自己收窄(图 ④):
| \(\lambda\) | 0–1k | 1–3k | 3–6k | 6–9k | 9–12.6k |
|---|---|---|---|---|---|
| 0.1 | +0.0102 | +0.0216 | +0.0265 | +0.0310 | +0.0212 |
| 0.5 | +0.0066 | +0.0154 | +0.0259 | +0.0315 | +0.0268 |
| 2.0 | +0.0739 | +0.1012 | +0.1085 | +0.0915 | +0.0719 |
两条机制¶
(a) 真实的目标冲突。 λ=2.0 把 \(\mathcal{L}_{\text{ortho}}\) 从 0.196 压到 0.043(−0.153), 代价是 \(\mathcal{L}_{\text{FM}}\) +0.072。两个目标共用同一组权重: 正交约束逼 \(A\) 转向与语音包络不对齐的方向(§9.4 里帧间一致性 −28%), 而那些方向拟合速度场本来就更差。这是 Pareto 交换,不是优化失败。
(b) ~~grad_clip=1.0 压缩了 FM 分量的有效步长~~ —— 这条我写错了,见下方更正。
| \(\lambda\) | grad_norm 中位 |
均值 | 被裁剪的步 |
|---|---|---|---|
| 0 | 4.03 | 5.24 | 100% |
| 0.01 | 3.66 | 4.84 | 100% |
| 0.1 | 7.59 | 12.21 | 100% |
| 0.5 | 7.00 | 9.25 | 100% |
| 2.0 | 4.10 | 8.79 | 100% |
更正(2026-08-27):AdamW 会吸收掉均匀的梯度缩放
我原本写「阈值 1.0 而 grad_norm 中位 3.7–7.6,所以有效步长 \(=\text{lr}/\lVert g\rVert\),
λ 抬高 \(\lVert g\rVert\) 就等比压缩 FM 分量」。这个推理对 SGD 成立,对 AdamW 不成立。
优化器是 torch.optim.AdamW。更新量是 \(m/(\sqrt{v}+\epsilon)\),
把梯度整体乘以常数 \(c\) 会让 \(m \to cm\)、\(\sqrt{v} \to c\sqrt{v}\),比值不变。
裁剪正是一个均匀标量缩放,所以 λ 造成的 \(\lVert g\rVert\) 整体抬升被 Adam 基本吸收。
裁剪 100% 生效仍然是事实,它的真实作用是拉平不同步之间的梯度幅度差异 (大梯度步被相对压低),而不是整体降低学习率。 因此「λ=0.1 的有效步长只剩 53%」这个说法作废。
剩下的解释只有 (a)。 而 (a) 本身就够:\(\mathcal{L}_{\text{ortho}}\) 的梯度 把权重拉离 FM 最优点,正则项一旦收敛,这个拉力就消失。
裁剪仍值得单独查一次
grad_clip=1.0 对 grad_norm 常态 4–12 的训练来说确实很紧,所有实验(含 v4)都是 100% 裁剪。
Adam 吸收了其中的均匀部分,但「每步都被拉平」是否影响收敛速度,没有直接证据。
这不影响 M11a 的组间对照(五组同样受此约束),仍登记为 G9 待验。