M21-E5 · v_Δ 编码了什么¶
| 状态 | ✅ 完成(二轮重做,2026-09-05) |
| 一句话 | 两问:① 把残差塔的输出 v_Δ 沿时间平均后,它更像"说话人"还是更像"情感"?② 如果推理时把逐帧 v_Δ 换成一个常向量(只保留幅度、方向固定),情感和音频还在吗? |
| 模型 | M20@420k |
| 规模 | ① 1020 个 v̄_Δ(ESD-zh test 全部四情感齐全的 255 条文本 × 4);② 160 条 × 4 臂 |
TL;DR¶
v_Δ 是一个逐帧变化的位移场:压成常向量后音频直接垮掉(UTMOS 2.66 → 1.36,CER 0.04 → 0.39), 且用"自己的平均方向"和"别人的平均方向"一样垮 ⇒ 丢的是时间结构,不是方向来源。
- 时间平均后的 v̄_Δ:同人不同话同情感的相似度 0.83,不同人同情感只有 0.36(基线 0.21);GT 残差同一格局(0.78 / 0.36) ⇒ 这是平行语料本身的结构,不是模型偏差
- 轮廓系数按情感 −0.02、按说话人 −0.10:两种标签都不成簇,相似度由(说话人 × 情感)联合决定
- 四臂对照:self_avg / cross / centroid 三条同等程度地崩(UTMOS 1.36 / 1.40 / 1.40)
- ⚠️ RA 在崩坏音频上不可解释(读出 1.6–2.4,见 E4 §1),本页用 UTMOS / CER / SECS 判
1 评测设计¶
1.1 v̄_Δ 相似度¶
| 项 | 值 |
|---|---|
| 采集 | teacher-forced:t=0.5、x_α 取中立/情感等权混合,取残差塔输出 v_Δ (80×K),沿时间平均 → 80 维,L2 归一 |
| 对照 | GT 残差 x1_emo − x1_neu 的时间平均,同样处理 |
| 配对类型 | A 同人同话·不同情感 · B 不同人不同话·同情感 · C 同人不同话·同情感 · D 全不同(基线) |
| 统计 | 各类型余弦均值;轮廓系数(cosine)按情感 / 按说话人 |
1.2 常向量替换(四臂)¶
推理时 v = v_B + α·v_Δ,α=1。对 v_Δ 做替换:保留每帧的幅度 ‖v_Δ[k]‖,把方向换成一个固定单位向量 u。
| 臂 | u 来自 | 检验什么 |
|---|---|---|
self |
不替换(逐帧 v_Δ) | 基线 |
self_avg |
本条自己的 v_Δ 时间平均方向 | 只丢时间结构、不换来源 ← 关键对照 |
cross |
另一位说话人同情感的 v̄_Δ | 换来源 |
centroid |
同情感全体说话人 v̄_Δ 的均值 | "通用情感方向" |
若 self_avg 与 cross 一样差,说明崩坏来自时间结构的丢失,与方向来源无关。
2 结果¶
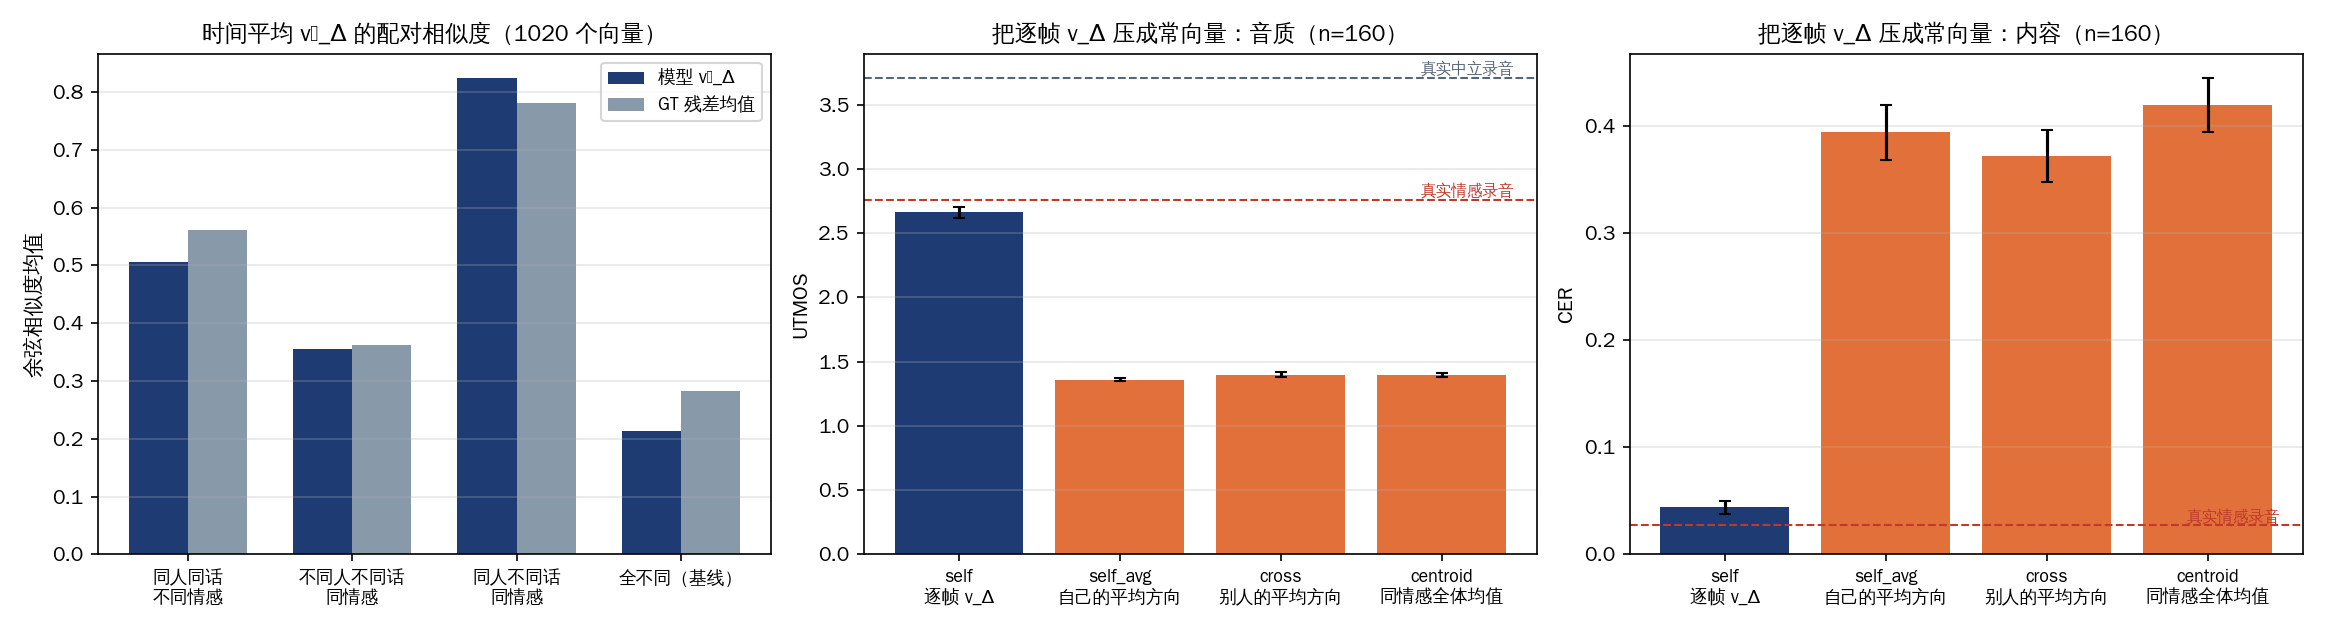
2.1 时间平均 v̄_Δ 的配对相似度(1020 个向量)¶
| 配对类型 | 对数 | 模型 v̄_Δ | GT 残差均值 |
|---|---|---|---|
| A 同人同话 · 不同情感 | 1,530 | 0.51 | 0.56 |
| B 不同人不同话 · 同情感 | 112,628 | 0.36 | 0.36 |
| C 同人不同话 · 同情感 | 13,828 | 0.83 | 0.78 |
| D 全不同(基线) | 337,884 | 0.21 | 0.28 |
| 轮廓系数 按情感 / 按说话人 | −0.02 / −0.10 | −0.06 / −0.18 |
- C ≫ A > B > D:换人(0.83 → 0.36)比换情感(0.83 → 0.51)更能改变 v̄_Δ
- 模型与 GT 格局一致(四个数两两相差 ≤ 0.07)⇒ 这是平行语料(同人同句录四情感)的性质,模型只是忠实地学到了
- 轮廓系数两者都 ≤ 0:既不按情感成簇,也不按说话人成簇——"同人同情感"才相似,单一标签都不足以定义簇
2.2 常向量替换:四臂(n=160)¶
| 臂 | UTMOS | CER | SECS | RA(仅供参考) |
|---|---|---|---|---|
| self(逐帧 v_Δ) | 2.66 | 0.044 | 0.942 | 1.00 |
| self_avg(自己的平均方向) | 1.36 | 0.394 | 0.857 | 1.63 ⚠️ |
| cross(别人的平均方向) | 1.40 | 0.372 | 0.825 | 1.66 ⚠️ |
| centroid(同情感全体均值) | 1.40 | 0.419 | 0.852 | 2.37 ⚠️ |
| 真实中立 / 真实情感录音 | 3.71 / 2.76 | 0.009 / 0.027 | 0.886 / 1.000 | 0.08 / 1.07 |
- 三条替换臂同等崩坏:UTMOS 1.36–1.40(比 self 低 1.3),CER 0.37–0.42(乱说),SECS 掉 0.08–0.12
- self_avg ≈ cross ≈ centroid ⇒ 崩的原因是"把逐帧方向压成常向量",与用谁的方向无关
- RA 读出 1.6–2.4 不是"更有情感"——崩坏音频的 eGeMAPS 大幅偏离中立分布,RA 把偏离读成强度。 这是 RA 的已知适用边界(E4 §1),退化值 self_avg 4 / cross 7 / centroid 11 条已剔除
2.3 图上看:v̄_Δ 谁跟谁近¶
补充实验 S2(提案待验收)。
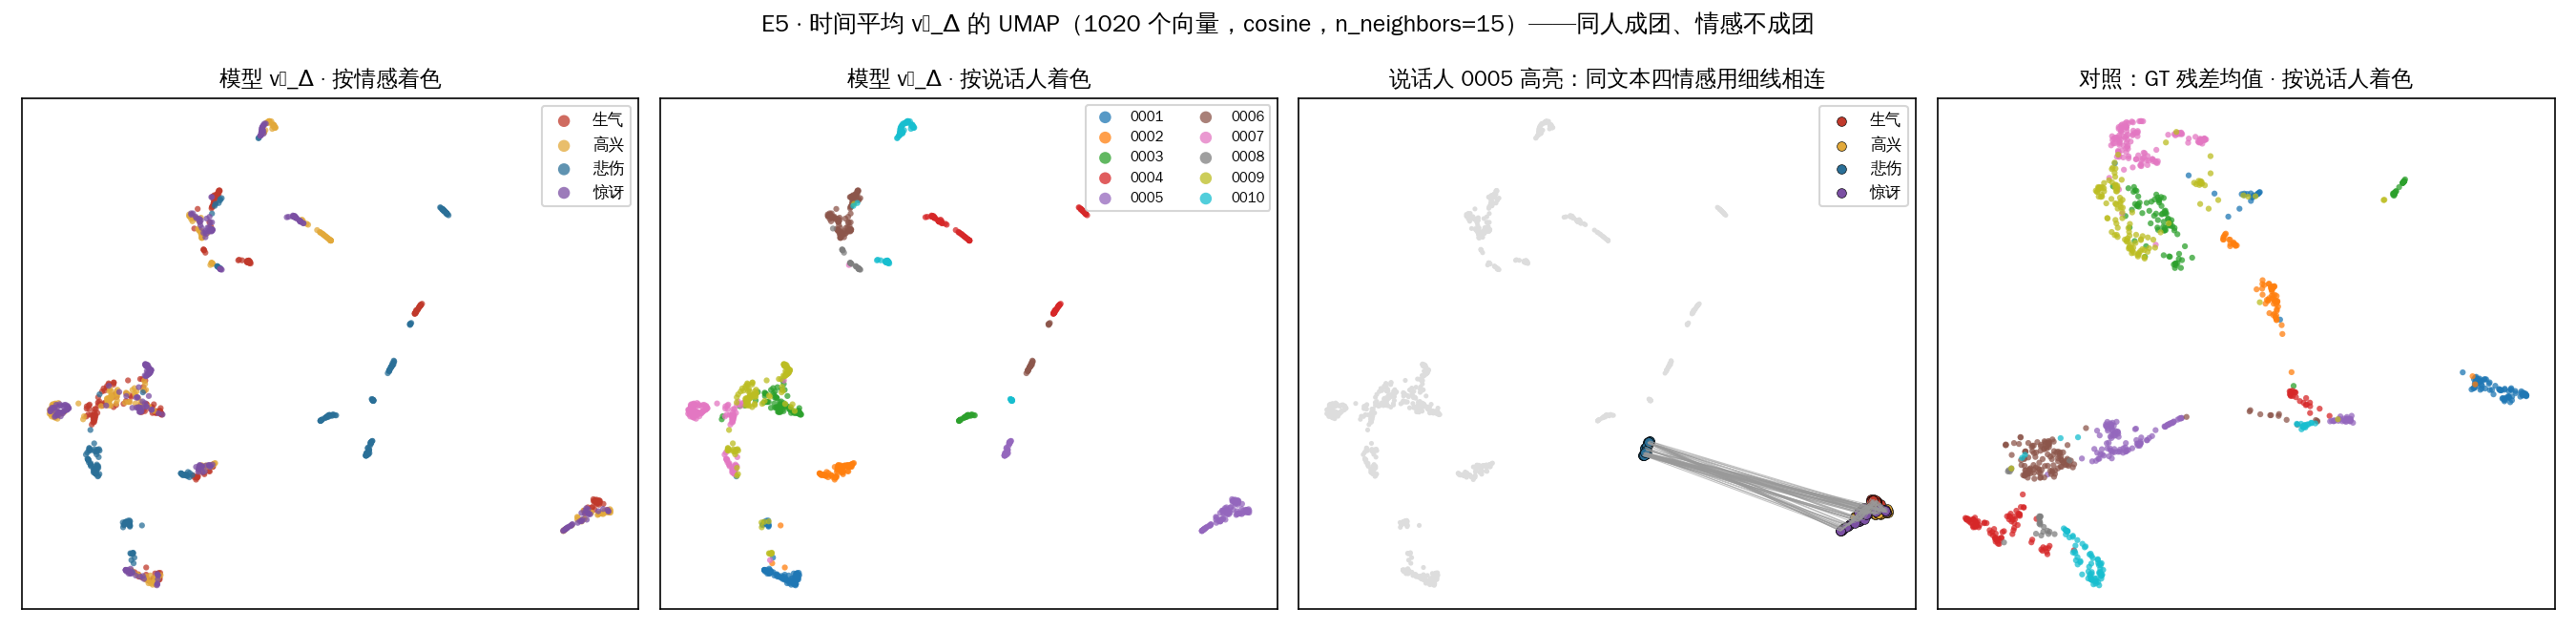
UMAP(cosine,n_neighbors 15)投影 1020 个时间平均 v̄_Δ,四个面板:
- 按情感着色(左一):四种颜色混在每一团里——不按情感成团
- 按说话人着色(左二):每团基本单色——按说话人成团;这是 §2.1 表中 C(同人同情感 0.83)≫ B(异人同情感 0.36)的图示
- 单说话人高亮(左三):把说话人 0005 的全部点标出、同一文本的四种情感用细线相连——该说话人的点分成两团,同文本的四情感跨团相连, 说明团内是"同人 + 某几种情感",不是"同人"或"同情感"单独定义的
- GT 残差对照(右一):真实录音的残差均值同样按说话人成团 ⇒ 这是平行语料的结构,模型忠实复现
图与 §2.1 的轮廓系数一致(按情感 −0.02、按说话人 −0.10):说话人成团肉眼可见,但团与团的距离不比团内大多少,所以系数不高。
真实录音本身也是这个格局——见补充 S2(提案待验收):3 位说话人 × 5 情感 × 3 句的声学分布,说话人 > 情感 > 内容。
全量复核(M21-F,2026-09-10)
汇总页 补充 S7(提案待验收,验收后回填)。
四臂在全量 1276 条上重跑(M21-F),图 m21_e5_v2_full.png:
| 臂 | UTMOS | CER | SECS | RA(仅供参考) |
|---|---|---|---|---|
| self | 2.67 | 0.047 | 0.939 | 0.94 |
| self_avg | 1.35 | 0.396 | 0.858 | 1.66 |
| cross | 1.41 | 0.385 | 0.828 | 1.57 |
| centroid | 1.39 | 0.415 | 0.854 | 2.36 |
与 160 条版逐格差 ≤ 0.03:三条常向量臂同等崩坏(UTMOS 1.36–1.41、CER 0.39–0.42),self_avg ≈ cross 仍成立。相似度分析(§2.1)本就基于 1020 个向量,不变。
3 结论¶
| 项 | 结论 |
|---|---|
| v_Δ 的本质 | 逐帧变化的位移场,不是一个可以用单一方向概括的量;压掉时间结构音频即崩 |
| 时间平均表示 | 由(说话人 × 情感)联合决定;换人比换情感影响大;与 GT 格局一致,是平行语料的性质 |
| 跨说话人迁移 | 用 v̄_Δ 这类时间平均表示做迁移不可行(不是因为说话人绑定,是表示本身丢了信息);真正的跨说话人测试见 E3 §2.3 |
| α 的可解释性 | α 缩放的是一个逐帧场;"α 沿某个情感方向走多远"的理解不成立 |
4 复现¶
source scripts/env.sh
CUDA_VISIBLE_DEVICES=7 $PY emo/exp/M17_editor/m21_e5_probe_v2.py           # 1020 个 v̄_Δ
for s in 0 1; do CUDA_VISIBLE_DEVICES=$((s+4)) $PY emo/exp/M17_editor/m21_e5x_gen.py --shard $s --nshard 2 & done; wait
bash emo/exp/M17_editor/run_m21v2_score.sh e5v2 4 5
$PY emo/exp/M17_editor/m21_e5_analyze.py
订正记录(2026-09-05)
首轮 128 个向量 / 11 条四臂(P6)的数字已被本轮取代;结论方向不变。 首轮四臂用 emotion2vec"情感分"(0.909 → 0.176)判情感丢失,本轮改为 UTMOS/CER/SECS 判音频崩坏—— 崩坏的音频谈不上"情感是否保留"。首轮"按说话人轮廓 +0.07"在 1020 个向量上变为 −0.10,"说话人主导"改述为"联合决定"。