M21-E3 · 泛化边界:英文 · 未见说话人 · 外部语料¶
| 状态 | ✅ 完成(二轮重做,2026-09-05) |
| 一句话 | 同一个模型、同一套指标,把输入从训练域(中文 ESD)推到英文 ESD(训练见过的说话人)和 CREMA-D(未见说话人 + 外部录音条件),看强度旋钮的哪一部分还成立 |
| 模型 | M20@420k,训练数据 = ESD 中文 + 英文共 17 位说话人 |
| 规模 | 中文 160 条(E4 直路)· 英文 160 条 · CREMA-D 144 条情感输入 + 47 条中立锚点 |
TL;DR¶
旋钮的单调性在三个域上都成立;退化的是三样东西——中立化的深度、说话人身份、以及绝对刻度。
- ✅ RA 在三个域上都随 α 单调上升到 1.5
- ⚠️ 未见说话人上,模型把低强度输入拉向高强度:CREMA-D「低」档输入(真人标 RA 0.15)经 α=1 重建后变成 0.62; 「高」档(1.10)重建成 1.13——高保真,低失真。模型带着 ESD 的强度先验
- ⚠️ 中立化到不了外部库的中立:CREMA-D 真实中立 −0.20,模型 α=0 只到 0.16;三档输入的 α=0 都收敛到同一个 0.13–0.17
- ⚠️ 说话人身份在未见说话人上丢:SECS 0.78,低于该说话人自己中立录音的 0.82(中文域是 0.94 > 0.89)
- 🔍 英文(训练见过):α=0 的 CER 0.09,反而好于中文的 0.22;中段谷深度 34% vs 中文 39%,差别不大
1 评测设计¶
| 域 | 输入 | 条件来源 | 说话人 | 与训练的关系 |
|---|---|---|---|---|
| 中文 ESD | test 随机 160 条 | 缓存 | 0001–0010 | 训练语言、训练说话人 |
| 英文 ESD | test 随机 160 条(四情感各 40) | 缓存 | 0011 / 0015–0020 | 训练见过说话人;此前评测口径只有中文 |
| CREMA-D | 16 位演员 × ANG/HAP/SAD × LO/MD/HI = 144 条 | 在线:whisper encoder + campplus 现场提取 | 全部未见 | ❗ 未见说话人、未见录音条件、外部语料 |
| 项 | 值 |
|---|---|
| α 网格 | 0 / 0.25 / 0.5 / 0.75 / 1 / 1.25 / 1.5,直路 |
| 指标 | E4 §1 质量评分体系;CER 中文用 Paraformer、英文用 whisper-large-v3 |
| 锚点 | 每个域自己的真实中立 / 真实情感录音;RA 归一 = (RA − 该域真实中立) / (该域真实情感 − 该域真实中立) |
| CREMA-D 的 CER | 本地子集只有一句 "It's eleven o'clock"(whisper 写作 11),参考取两种写法的较小值 |
两条声明:① ESD 的 17 位说话人全部在训练集内,ESD 内不存在未见说话人,L2 只能靠 CREMA-D; ② CREMA-D 本地子集单句,CER 只能做相对比较;其录音条件使 UTMOS 对原声打 1.55,UTMOS 在该域不作锚点。
2 结果¶
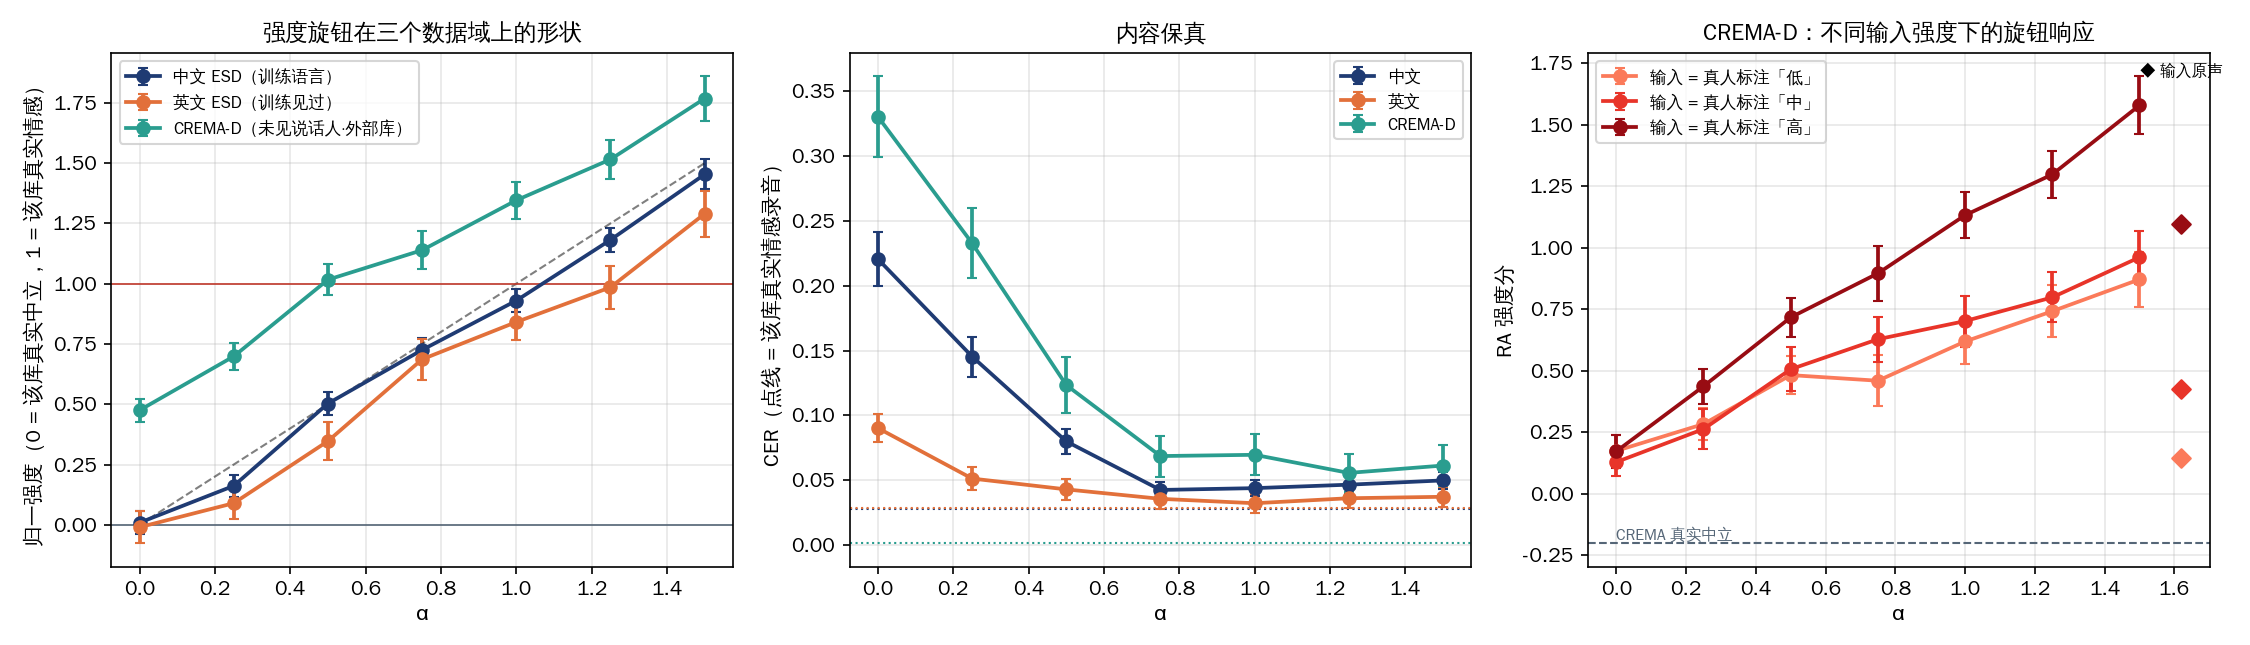
2.1 三个域的 α 曲线¶
归一强度(0 = 该域真实中立,1 = 该域真实情感):
| α | 0 | 0.25 | 0.5 | 0.75 | 1.0 | 1.25 | 1.5 |
|---|---|---|---|---|---|---|---|
| 中文 ESD | 0.01 | 0.16 | 0.50 | 0.73 | 0.93 | 1.18 | 1.45 |
| 英文 ESD | −0.01 | 0.09 | 0.35 | 0.69 | 0.84 | 0.99 | 1.29 |
| CREMA-D | 0.48 | 0.70 | 1.02 | 1.14 | 1.35 | 1.52 | 1.77 |
原始值与锚点:
| 域 | 指标 | α=0 | α=0.5 | α=1 | α=1.5 | 真实中立 | 真实情感 |
|---|---|---|---|---|---|---|---|
| 英文 | RA | 0.25 | 0.42 | 0.67 | 0.89 | 0.25 | 0.75 |
| UTMOS | 3.15 | 2.28 | 3.43 | 3.31 | 4.20 | 3.64 | |
| CER | 0.090 | 0.043 | 0.032 | 0.037 | 0.025 | 0.029 | |
| SECS | 0.865 | 0.900 | 0.929 | 0.921 | 0.901 | 1.000 | |
| CREMA-D | RA | 0.16 | 0.57 | 0.82 | 1.14 | −0.20 | 0.56 |
| UTMOS | 2.92 | 2.08 | 2.87 | 2.77 | 1.57 ⚠️ | 1.55 ⚠️ | |
| CER | 0.331 | 0.123 | 0.070 | 0.061 | 0.000 | 0.001 | |
| SECS | 0.717 | 0.764 | 0.779 | 0.777 | 0.820 | 1.000 |
(中文行见 E4 §3.1;各格 n=160 / 144,RA 标准误 0.03–0.07)
2.2 英文:训练见过的说话人¶
- RA 刻度偏小:英文真实情感录音在中文训的排序器上只得 0.75(中文 1.07)——排序器的刻度部分是语言特定的; 归一后英文 α=1 达 0.84(中文 0.93),形状相同、略弱
- α=0 的 CER 0.09 明显好于中文的 0.22——中文的 α=0 乱说(E4 §3.5)在英文上轻得多
- 中段谷同样存在:α=0.5 的 UTMOS 比 α=1 低 34%(中文 39%)。首轮报"英文谷更浅 21% vs 40%"建在 12 组上,不成立
- 位移保真(E7 口径):cos(Δ_model, Δ_target) 0.80(中文 0.93),‖Δ_model‖/‖Δ_target‖ 0.96, cos(Δ_target, Δ_raw) 0.85(中文 0.99),逐维达成率中位 0.92。目标构造和模型在英文上都略失真,但达成率仍在
2.3 CREMA-D:未见说话人 + 外部语料¶
按输入的真人标注强度档拆开:
| 输入档 | 输入原声 RA | α=0 | α=0.5 | α=1 | α=1.5 | α=1 − 原声 |
|---|---|---|---|---|---|---|
| 低 LO | 0.15 | 0.17 | 0.48 | 0.62 | 0.87 | +0.47 |
| 中 MD | 0.42 | 0.13 | 0.51 | 0.70 | 0.96 | +0.28 |
| 高 HI | 1.10 | 0.17 | 0.72 | 1.13 | 1.58 | +0.03 |
| CREMA 真实中立 | −0.20 |
三个读数:
- α=1 应当是"重建输入",但只对高强度输入成立(1.13 vs 1.10)。低/中档输入被抬高 0.47 / 0.28 ⇒ 模型带着训练分布的先验(ESD 是清一色的高强度表演语音),把弱情感往强情感拉
- α=0 对三档输入收敛到同一个 0.13–0.17——中立化确实抹掉了输入强度的差异, 但这个"中立"比 CREMA-D 真实中立(−0.20)高 0.36。模型的中立是 ESD 的中立
- 说话人身份:α=1 的 SECS 0.78 < 该说话人自己中立录音的 0.82。中文域是 0.94 > 0.89。 未见说话人上,输出更像"ESD 里的某个人"而不是输入的那个人
内容:α=0 的 CER 0.33(中文 0.22、英文 0.09),α ≥ 0.75 降到 ≤ 0.07。中立化在未见说话人上最伤内容。
全量复核(M21-F,2026-09-10)
汇总页 补充 S7(提案待验收,验收后回填)。
英文 ESD 全量 861 条(M21-F);中文列同为 1276 条。图 m21_e3_ood_full.png。
| α | 0 | 0.25 | 0.5 | 0.75 | 1.0 | 1.25 | 1.5 |
|---|---|---|---|---|---|---|---|
| 中文 归一强度 | 0.00 | 0.16 | 0.48 | 0.71 | 0.91 | 1.14 | 1.42 |
| 英文 归一强度 | -0.03 | 0.10 | 0.36 | 0.68 | 0.86 | 1.05 | 1.33 |
| 英文 CER(whisper) | 0.090 | 0.056 | 0.044 | 0.040 | 0.037 | 0.038 | 0.041 |
英文锚点:真实中立 RA 0.27、真实情感 0.77。α=0 CER 0.090(中文 0.250)——英文中立化更干净在全量上成立。 英文位移保真(E7 口径,n=861):cos(Δ_model, Δ_target) 0.858(160 条 0.80)、幅度比 1.06、cos(Δ_target, Δ_raw) 0.941(160 条 0.85)、达成率中位 0.95——160 条时的"英文目标构造失真"是小样本噪声,全量上英文与中文(0.937 / 0.972)接近。 CREMA-D 部分本来就是全量,数字不变。
3 结论¶
| 项 | 中文(训练域) | 英文(见过说话人) | CREMA-D(未见) |
|---|---|---|---|
| 强度单调性 | ✅ | ✅ | ✅ |
| α=1 归一强度 | 0.93 | 0.84 | 1.35(低档输入被抬到 0.62 / 0.15) |
| α=0 归一强度 | 0.01 | −0.01 | 0.48(到不了该库的中立) |
| α=0 CER | 0.22 | 0.09 | 0.33 |
| SECS@α=1 vs 同人中立 | 0.94 > 0.89 ✅ | 0.93 > 0.90 ✅ | 0.78 < 0.82 ❌ |
| 中段谷深度 | 39% | 34% | — |
泛化边界:旋钮的相对控制(单调、按 α 递增)跨域成立;绝对刻度、中立化深度和说话人身份是训练分布的产物, 出了训练说话人就漂移。要在未见说话人上用,得先解决"低强度输入被抬高"——这是数据分布问题, 需要非表演、含低强度样本的训练语料。
4 复现¶
source scripts/env.sh
for s in 0 1 2 3; do CUDA_VISIBLE_DEVICES=$((6+s%2)) $PY emo/exp/M17_editor/m21_e3_gen.py --set en --shard $s --nshard 4 & done
for s in 0 1 2 3; do CUDA_VISIBLE_DEVICES=$s $PY emo/exp/M17_editor/m21_e3_gen.py --set crema --shard $s --nshard 4 & done; wait
bash emo/exp/M17_editor/run_m21v2_score.sh e3en 6 7; bash emo/exp/M17_editor/run_m21v2_score.sh e3crema 6 7
$PY emo/exp/M17_editor/m21_e3_analyze.py
订正记录(2026-09-05)
首轮 L1(12 组、24 kHz、emotion2vec delta)的"英文谷更浅 21%"与"delta 0.606 vs 0.903"已废; L2/L3 首轮因下载未完成而空缺,本轮以 CREMA-D 完成。RA 退化值剔除:中文 9、英文 2、CREMA-D 0。