M21-E2 · 情感强度指标¶
| 状态 | ✅ 完成(2026-09-03 定稿) |
| 一句话 | 造一把能量"情感强度"的尺子,并用真人标注证明这把尺子可信;然后用它给出 α 旋钮的刻度表 |
| 上游 | ← M21 总提案 · 测量对象 = M20@420k 的 α 旋钮 |
| 下游 | → E7 回答"强度在声学上是什么" |
TL;DR¶
α=0 的中立化与真实中立录音统计上不可区分(0.091 vs 0.082),α=1 达到真实情感强度的 89%。 但 α 刻度不是等间隔的——α=0.25 只兑现名义强度的 66%。
- ❌ 项目此前用的 emotion2vec 分类概率不能测强度:92% 的分数被压在 0 或 1(§1)
- ✅ 改用两个文献方法:相对属性排序(主)+ arousal(副)(§2)
- ✅ 外部验收:在 CREMA-D 的真人强度标注上,中文训练的排序器直接套用到英文库, 四档落在 −0.22 / +0.15 / +0.42 / +1.10——刻度基本原样迁移(§4.3)
- ⚠️ 只报相关系数会掩盖刻度问题:ρ组内 0.914,但按条中心化 CCC 仅 0.537
1 为什么要换指标¶
项目此前用 emotion2vec 的分类概率当强度读数。把它放到一个已知强度的阶梯上一测就露馅:
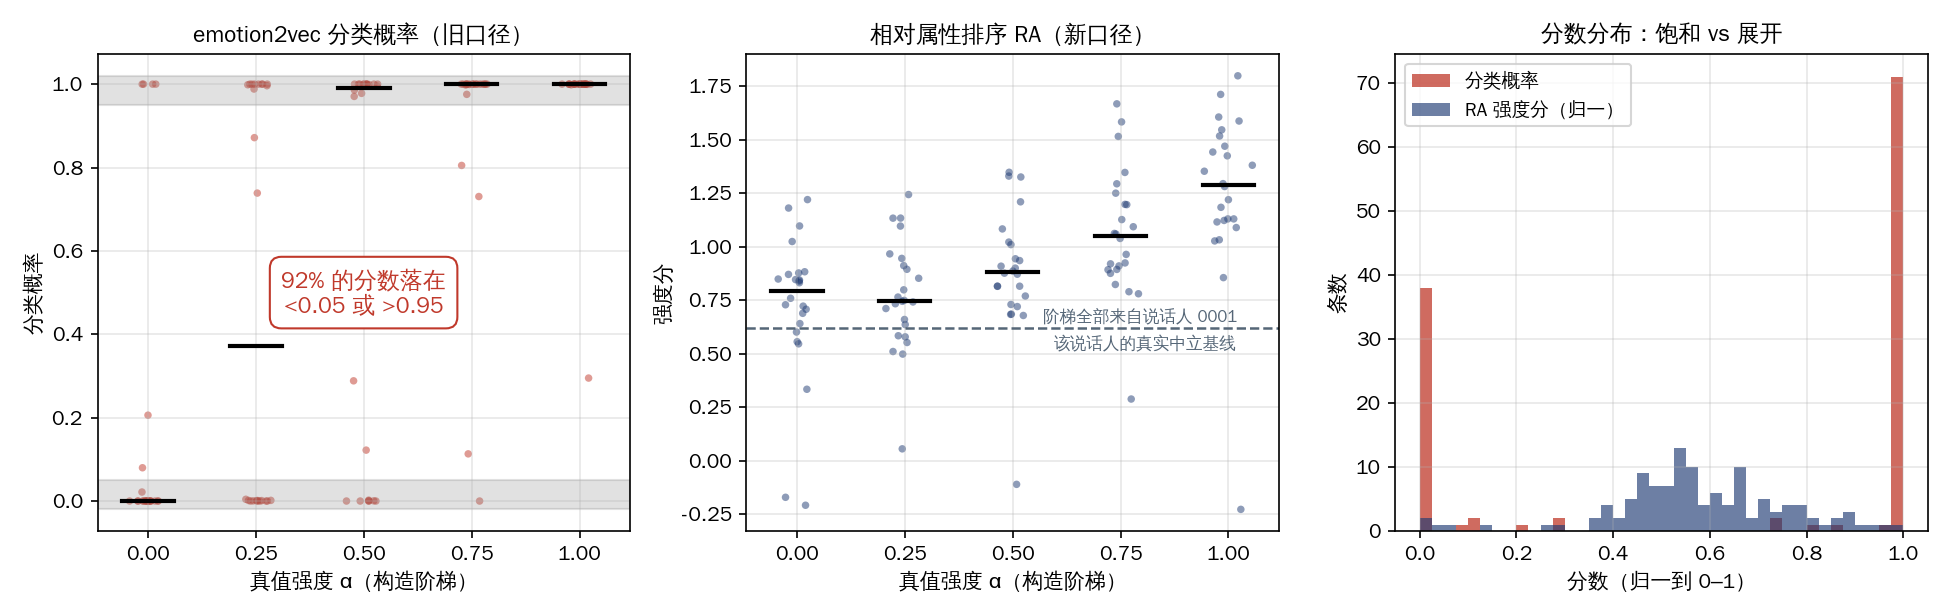
- 左:分类概率在 α=0.25 就已经跳到中位 0.37、α=0.5 已经饱和到 0.99。 92% 的分数落在 <0.05 或 >0.95,相邻强度档的 AUC 仅 0.618(≈瞎猜)
- 中:相对属性排序在同一批音频上平滑上升,档与档之间分得开
- 右:分布对比——一个是两根柱子,一个是连续展开
结论:分类概率回答的是"是不是生气",不是"有多生气"。 此前各实验的 emotion2vec delta 读数只应作"情感是否翻转"用。
中图的绝对高度偏高,是说话人平移
该阶梯 120 条全部来自说话人 0001,其真实中立录音的 RA 基线本身就是 +0.62 (十位说话人从 −0.60 到 +0.78)。RA 的绝对刻度随说话人平移, 所以绝对值必须配同批锚点读——这正是 §4.1 的做法。
2 指标¶
2.1 主指标:相对属性排序(Relative Attributes)¶
| 项 | 内容 |
|---|---|
| 出处 | Parikh & Grauman, Relative Attributes, ICCV 2011(方法);Zhou et al., Emotion Intensity and its Control for Emotional Voice Conversion, IEEE TAFFC 2022(用在语音情感强度上,arXiv:2201.03967) |
| 思路 | 强度没有绝对真值,但序是可靠的:中立一定比情感弱。用这个序训一个排序器,它就能给任意单条音频打出连续强度分 |
| 特征 | eGeMAPSv02 88 维(Eyben et al., IEEE TAFFC 2016),opensmile 提取 |
| 模型 | RankSVM:对「情感 − 中立」的成对差做线性 SVM(LinearSVC,C=0.1,无截距) |
| 训练数据 | ESD 中文 train 划分,说话人 ≤0010,每类 150 条;四种情感各训一个排序器 |
| 刻度 | 用两端定标:0 = 真实中立录音的均值,1 = 真实情感录音的均值 |
RA 的完整流程¶
flowchart LR
  subgraph T["训练(离线一次)"]
    direction TB
    A["ESD-zh train · 说话人 0001–0010<br/>中立 150 句 + 4 情感各 150 句"] --> B["openSMILE eGeMAPSv02<br/>每句 → 88 维句级统计量"]
    B --> C["z 标准化<br/>μ, σ 由 750 句估计并保存"]
    C --> D["对每种情感 e:<br/>P_i − N_i 标 +1,N_i − P_i 标 −1<br/>300 个差向量"]
    D --> E["LinearSVC(C=0.1, 无截距)<br/>→ 权重 w_e (88 维)"]
    E --> F["定标:lo_e = mean(z_N·w_e)<br/>hi_e = mean(z_P·w_e)"]
  end
  subgraph S["打分(每条新音频)"]
    direction TB
    G["音频 → 16 kHz → eGeMAPSv02 (88)"] --> H["z = (x − μ) / σ"]
    H --> I["s = z · w_e"]
    I --> J["RA = (s − lo_e) / (hi_e − lo_e)"]
  end
  F -. "μ σ, {w_e, lo_e, hi_e}" .-> H
训练五步
- 选样本:ESD 中文 train 划分、说话人 0001–0010;中立 150 句,生气 / 高兴 / 悲伤 / 惊讶各 150 句,共 750 句。
- 提特征:每句 16 kHz 音频 → openSMILE eGeMAPSv02 → 88 维。全部是整句统计量:F0 的均值 / 20-50-80 分位 / 上升斜率、响度的均值 / 分位 / 峰速率、 谱斜率、alpha ratio、Hammarberg 指数、MFCC1–4 均值、jitter、shimmer、谐噪比、有声段长度与速率……一句话变成一个点。
- 标准化:用 750 句估每维的 μ、σ,z = (x − μ)/σ。μ、σ 存下来,打分时用同一套。
- 对每种情感 e 各训一个排序器:取该情感 150 句 z 向量为 P、中立 150 句为 N;打乱后按索引一一配对,
P_i − N_i 标 +1、N_i − P_i 标 −1,得 300 个差向量;在其上拟合
LinearSVC(C=0.1, fit_intercept=False)→ 88 维权重 w_e。 不要截距是因为排序比较的是两条音频之差,分界面须过原点;C 取小是 88 维只有 300 样本,防过拟合到个别维。 - 定标:把 N、P 分别投影 s = z·w_e,两组均值记 lo_e、hi_e。产物是一个 json:μ、σ、四组 {w, lo, hi}——4×88 个权重加几个标量,没有神经网络。
打分四行
x   = eGeMAPSv02(音频 @16kHz)            # 88 维
z   = (x − μ) / σ                        # 训练时存的 μ σ
s   = z · w_e                            # 选该音频所属情感的 w
RA  = (s − lo_e) / (hi_e − lo_e)         # 0 = 训练集中立均值,1 = 训练集该情感均值
例:生气排序器 lo=−1.2、hi=+2.3,一条音频投影得 s=0.55 → RA=(0.55+1.2)/3.5=0.50,即处在真人中立与真人生气正中间。 两条补充:中立音频没有对应的 w(评 CREMA-D 中立档时)→ 取三个排序器均值;|RA| 超出 [−3, 5] 判为退化并剔除(见下方警告)。
"排序"在哪——训练时学"差向量分类",推理时做"比大小",是同一件事:
右端正是训练时要求分类器对 (情感 − 中立) 差向量输出正号的条件。SVM 找到的 w 就是"情感一致地排在中立之上"的那个方向; 新音频往上一投影就得到它在中立→情感轴上的位置。中间值不是标签给的(标签只有 ±1),是特征连续、投影自然连续。
三个常问
| 问 | 答 |
|---|---|
| 为什么不直接训分类器取概率? | 分类器末端过 sigmoid,远离边界的样本全被推到 0 或 1——emotion2vec 92% 饱和就是这么来的(§1)。排序器输出未压缩的投影值,刻度保留 |
| 为什么每种情感单独一把尺? | 生气的轴(音高高、响度大、高频多)与悲伤的轴(谐噪比、气声)方向不同,合成一把会互相抵消;代价是打分前须知情感类别 |
| 绝对值能跨说话人比吗? | 不能。十位说话人的中立录音本身在尺上从 −0.60 到 +0.78(§1 附注),所以各表都配同批真人录音锚点,跨条比看组内 ρ |
与 Zhou et al. 2022 原文实现的差异(我们沿用的是方法,排序器是用自己的数据重新训的,没有复用他们的权重):
| Zhou et al. 2022(原文 §4.2.2) | 本页 | |
|---|---|---|
| 训练语料 | ESD,随机选一位男性说话人,每情感 300 句(英文侧,与其 Interspeech 2021 协议一致) | ESD 中文 train,10 位说话人 0001–0010,每类 150 句(共 750) |
| 声学特征 | openSMILE Interspeech 2009 Emotion Challenge 集,384 维 | openSMILE eGeMAPSv02,88 维(Eyben 2016 的标准化最小集) |
| 排序器 | RankSVM,第三方实现(chaitanya100100/Relative-Attributes-Zero-Shot-Learning),每情感一个 | LinearSVC 拟合成对差,每情感一个 |
| 约束 | 有序对(情感 > 中立)+ 相似对(中立–中立、情感–情感) | 只用有序对 |
| 刻度 | 训练集上 min-max 归一到 [0, 1] | 0 = 真实中立均值、1 = 真实情感均值(两端定标) |
| 用途 | 给 EVC 训练数据打强度标签,作条件输入 | 评测指标 |
| 效度验证 | 听测(MOS / BWS) | 构造阶梯 + CREMA-D 真人三档标注(§4.3) |
原文源码与样例:kunzhou9646.github.io/Emovox_demo;排序器权重是否公开,原文未说明。
为什么这个刻度重要:分数不是任意单位,0 和 1 都对应真实录音。 "α=1 打 0.997"直接读作"达到了真人情感录音的水平"。
四个排序器的中立/情感可分度 d′:
| Angry | Surprise | Happy | Sad |
|---|---|---|---|
| 1.69 | 1.54 | 1.40 | 1.01 |
Sad 最弱 —— 归因见 E7 §3.4:悲伤的总声学位移只有生气/惊讶的 1/3, 且 36% 落在节奏/时长,而节奏正是本架构因 DTW 锁定时间轴而表达不了的通道。
2.2 副指标:维度情感模型的 arousal¶
| 项 | 内容 |
|---|---|
| 出处 | Wagner et al., Dawn of the Transformer Era in Speech Emotion Recognition, IEEE TPAMI 2023;模型 audeering/wav2vec2-large-robust-12-ft-emotion-msp-dim |
| 输出 | arousal / dominance / valence ∈ [0,1] |
| 作用 | 零训练、完全外部(MSP-Podcast,英文)——与本项目无任何共享成分,用作跨域印证 |
| 依据 | 以 arousal 作强度代理是 EmoSphere-TTS 等工作的通行口径 |
valence 是阴性对照:强度旋钮应当只动激活度、不动效价。 若 valence 也跟着 α 走,说明测的是"泛泛的音频差异"而非"强度"。
RA 的适用前提(2026-09-05 补)
RA 建在 eGeMAPS 上,崩坏音频会产生离谱值(E4 中 |α|≥2 的输出、E5 的常向量臂读出 1.6–2.4 甚至更高)—— 这是"偏离中立分布"被读成了"强度"。约定:|RA| 超出 [−3, 5] 判为退化并剔除;RA 只在 CER ≲ 0.1 的可懂音频上可解释。本页各表均在可懂音频上。
2.3 统计口径:ρ 与 CCC 都要报¶
| 统计量 | 管什么 | 为什么不能只报一个 |
|---|---|---|
| Spearman ρ(组内) | 单调性 | 只要 α 升分数就升,ρ 就高——刻度歪了它也看不出来 |
| CCC(一致性相关) | 刻度一致性 | 同时惩罚斜率偏差与偏移 |
ρ 取组内(每条音频内部按 α 排序再平均):不同说话人的绝对基线差异很大(见 §1 附注), 跨条混算会被基线方差主导。CCC 同理需按条中心化后再算。
3 评测设计¶
指标是一把尺子。"测这把尺子准不准"和"用这把尺子去量模型"是两件事, 分别用三批音频完成:
| 批次 | 层级 | 回答的问题 |
|---|---|---|
| 构造阶梯(120 条) | 测尺子 | 给一个已知的强度梯度,指标读得出来吗 |
| CREMA-D(191 条) | 测尺子 | 换成别人标的真人强度,还准吗 |
| 模型 α 扫描(160 条) | 用尺子 | ← 实验结果:旋钮拧到 0.5,实际给出多少强度 |
前两批是给尺子做的校准检验(§4.4 / §4.3), 第三批才是主结果(§4.1)。
3.1 测尺子:两个校准检验¶
| 构造阶梯 | CREMA-D | |
|---|---|---|
| 内容 | 真实中立与情感音频按音高对齐混合,混合比即真值强度;α∈{0,0.25,0.5,0.75,1},120 条 | 英文库,16 位演员 × 3 句 × ANG/HAP/SAD × 真人标注的 LO/MD/HI 三档 + 中立;191 条 |
| 真值来自 | 我们自己构造 | 真人标注 |
| 检验什么 | 指标有没有分辨率——连人为造出来的梯度都读不出来,尺子就是坏的 | 指标会不会只在我们自己造的东西上碰巧好使 |
| 独立性 | ⚠️ 自构造,见下方警告 | ✅ 完全外部:不同语言、不同录音条件、不同标注者 |
构造阶梯有一处循环性,已声明
阶梯按对数插值 F0 构造,所以任何以 F0 为主的指标在它上面都会天然得高分。 因此阶梯只用于"指标能否读出已知强度"的自检,不用于声学归因—— 那部分已移交 E7,改用不含 α 的位移分解。 CREMA-D 的存在正是为了补上这个漏洞。
3.2 用尺子:模型 α 扫描(主结果)¶
| 项 | 值 |
|---|---|
| 模型 | M20@420k(outputs/m20d/ckpts/step160000.pt),direct 臂 |
| 样本 | ESD test 划分随机 160 条(四情感各 40),与 E7 同一批 |
| α 网格 | 0 / 0.25 / 0.5 / 0.75 / 1.0 / 1.25 / 1.5 |
| 刻度锚点 | 同一批 160 条的真实中立录音与真实情感录音,另加训练目标两端 |
为什么必须另测真实录音:RA 的绝对分数随说话人平移—— 十位 ESD 说话人的真实中立基线从 −0.60 到 +0.78。 不配同批锚点,"α=0 打 0.091"这个数没法解读;配上锚点才能说 "它与真实中立录音的 0.082 不可区分"。
采样率统一 16 kHz:排序器训练于 16 kHz 的 ESD 录音,模型输出(24 kHz)一律重采后再打分。 实测该差异逐条可达 ±0.5,均值影响可忽略。
4 结果¶
4.1 主结果:α 的刻度表(n=160)¶
| α | 0 | 0.25 | 0.5 | 0.75 | 1.0 | 1.25 | 1.5 |
|---|---|---|---|---|---|---|---|
| RA 强度分 | 0.091 | 0.241 | 0.577 | 0.721 | 0.997 | 1.245 | 1.613 |
| ±SE | 0.048 | 0.045 | 0.046 | 0.089 | 0.048 | 0.050 | 0.095 |
| arousal | 0.404 | 0.458 | 0.598 | 0.616 | 0.612 | 0.621 | 0.643 |
| valence(对照) | 0.452 | 0.449 | 0.426 | 0.444 | 0.439 | 0.448 | 0.457 |
同批 160 条的真值锚点:
| 音频 | RA | arousal |
|---|---|---|
| 真实中立录音 | 0.082 ± 0.046 | 0.366 |
| 训练目标·中立(DTW 变速 + HiFT) | 0.135 ± 0.047 | 0.426 |
| 训练目标·情感(HiFT) | 1.130 ± 0.068 | 0.608 |
| 真实情感录音 | 1.099 ± 0.058 | 0.590 |
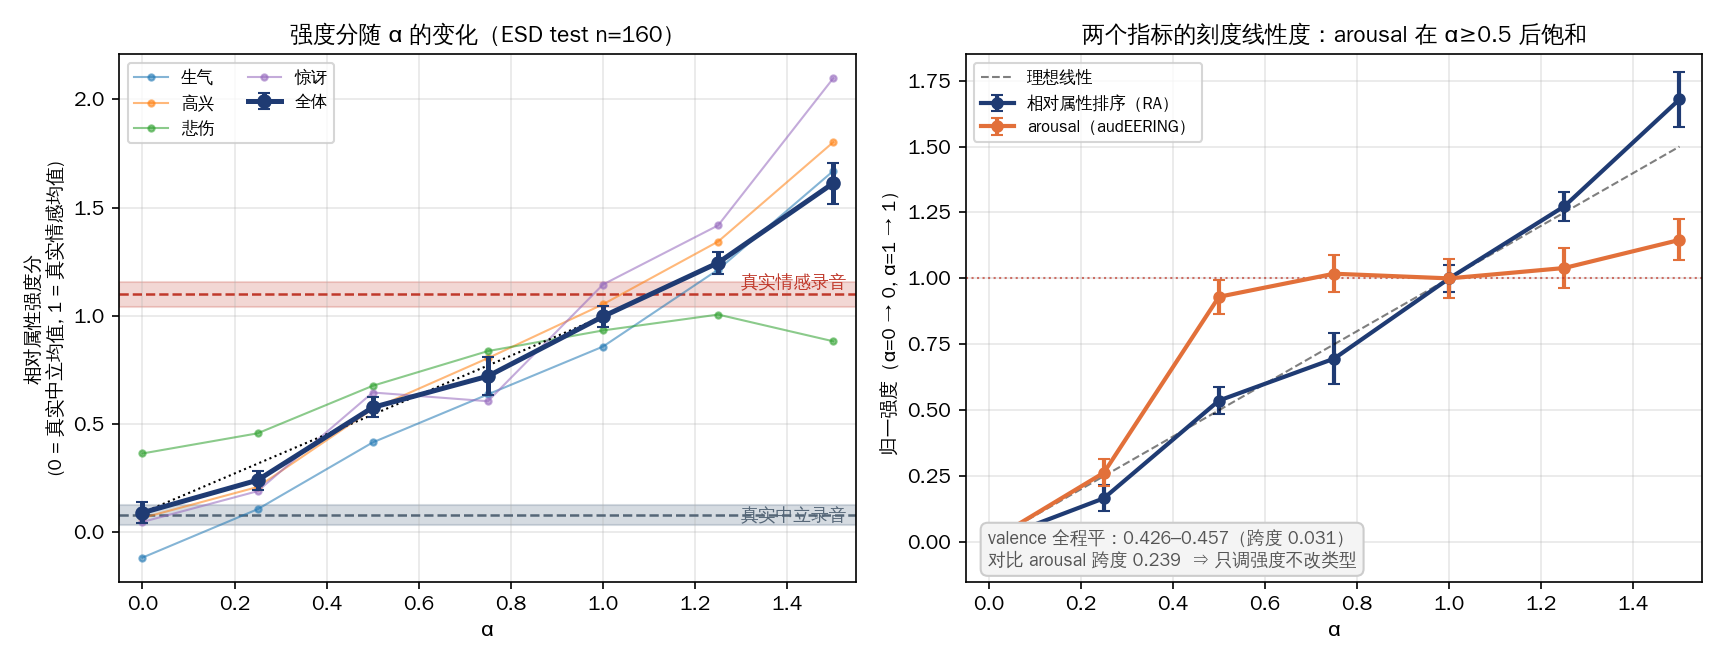
四条读法
- ✅ α=0 的中立化是干净的:0.091 vs 真实中立录音 0.082,差 0.009 —— 统计上不可区分
- ✅ α=1 基本到位:0.997 vs 真实情感 1.099,差 0.10(约 1.4σ,不显著); 可控跨度 0.91 = GT 跨度 1.02 的 89%
- ⚠️ α 刻度不是等间隔的:归一到 α=1 处为 1.0 后,各档兑现率 0.25 → 66%、0.5 → 107%、0.75 → 93%、1.25 → 102%、1.5 → 112%。 低档偏保守 ⇒ 用户拧到 0.25 拿到的强度只有名义的三分之二
- 🔍 arousal 在 α≥0.5 后饱和(0.598 / 0.616 / 0.612 / 0.621 / 0.643),而 RA 一路单调到 1.5 ⇒ arousal 只能区分"有没有情感",不能区分档位;副指标定位收窄为跨域方向性印证
统计量
| 统计量 | 值 |
|---|---|
| ρ组内(α∈[0,1]) | 0.914 |
| ρ组内(α∈[0,1.5]) | 0.906 |
| CCC(α∈[0,1],按条中心化) | 0.537 |
| CCC(α∈[0,1.5],按条中心化) | 0.614 |
ρ 0.914 但 CCC 只有 0.537——差距就是上面第三条量化的刻度非线性。 单调性很好,等间隔性不好。
全量复核(M21-F,2026-09-10)
汇总页 补充 S7(提案待验收,验收后回填)。 全量 zh test 1276 条(M21-F)重算 §4.1 主表,160 条版结论不变:
| α | 0 | 0.25 | 0.5 | 0.75 | 1.0 | 1.25 | 1.5 |
|---|---|---|---|---|---|---|---|
| RA(1276 条) | 0.065 | 0.219 | 0.530 | 0.749 | 0.943 | 1.164 | 1.436 |
| RA(160 条) | 0.091 | 0.241 | 0.577 | 0.721 | 0.997 | 1.245 | 1.613 |
锚点(1276 条):真实中立 0.065,真实情感 1.029。α=0 与真实中立仍不可区分(0.065 vs 0.065);α=1 达 GT 跨度的 91%。 兑现率(归一到 α=1):0.25 → 70%、0.50 → 106%、0.75 → 104%、1.25 → 100%、1.50 → 104%——α=0.25 只兑现七成这一条在全量上成立。
统计量订正:ρ组内(α∈[0,1])1276 条 0.910,160 条 0.914。中心化 CCC:1276 条 0.848;160 条按同口径(剔除退化 RA)重算为 0.860,本页此前写的 0.537 是未剔除退化值时算的,已作废。 ρ 与 CCC 的差距因此只有 0.06——刻度问题主要就是 α=0.25 那一档偏保守,其余档接近等间隔。
4.2 按情感¶
| 情感 | α=0 | 0.25 | 0.5 | 0.75 | 1.0 | 1.25 | 1.5 |
|---|---|---|---|---|---|---|---|
| Angry | −0.116 | 0.107 | 0.416 | 0.637 | 0.858 | 1.214 | 1.669 |
| Happy | 0.067 | 0.210 | 0.570 | 0.805 | 1.054 | 1.343 | 1.802 |
| Surprise | 0.048 | 0.191 | 0.646 | 0.606 | 1.145 | 1.418 | 2.098 |
| Sad | 0.365 | 0.458 | 0.677 | 0.838 | 0.933 | 1.006 | 0.883 |
悲伤是例外:α=0 起点 0.365(其他 −0.12 ~ 0.07)⇒ 中立化最不彻底; α=1.5 反而回落(1.006 → 0.883)⇒ 可控区间比其他情感更窄。 与 §2.1 的 d′ 最低、E7 §3.4 的节奏归因,三处独立证据指向同一个架构限制。
4.3 外部验收:CREMA-D 的真人强度标注¶
| 项 | 内容 |
|---|---|
| 数据 | CREMA-D(Cao et al., IEEE TAFFC 2014),16 位演员 × 3 句 × ANG/HAP/SAD × LO/MD/HI + NEU |
| 规模 | 191 条(本地子集) |
| 独立性 | 英文、不同录音条件、真人强度标注,与本项目的构造方式无任何关系 |
| 应用方式 | 排序器在中文 ESD 上训练,不做任何微调直接打分 |
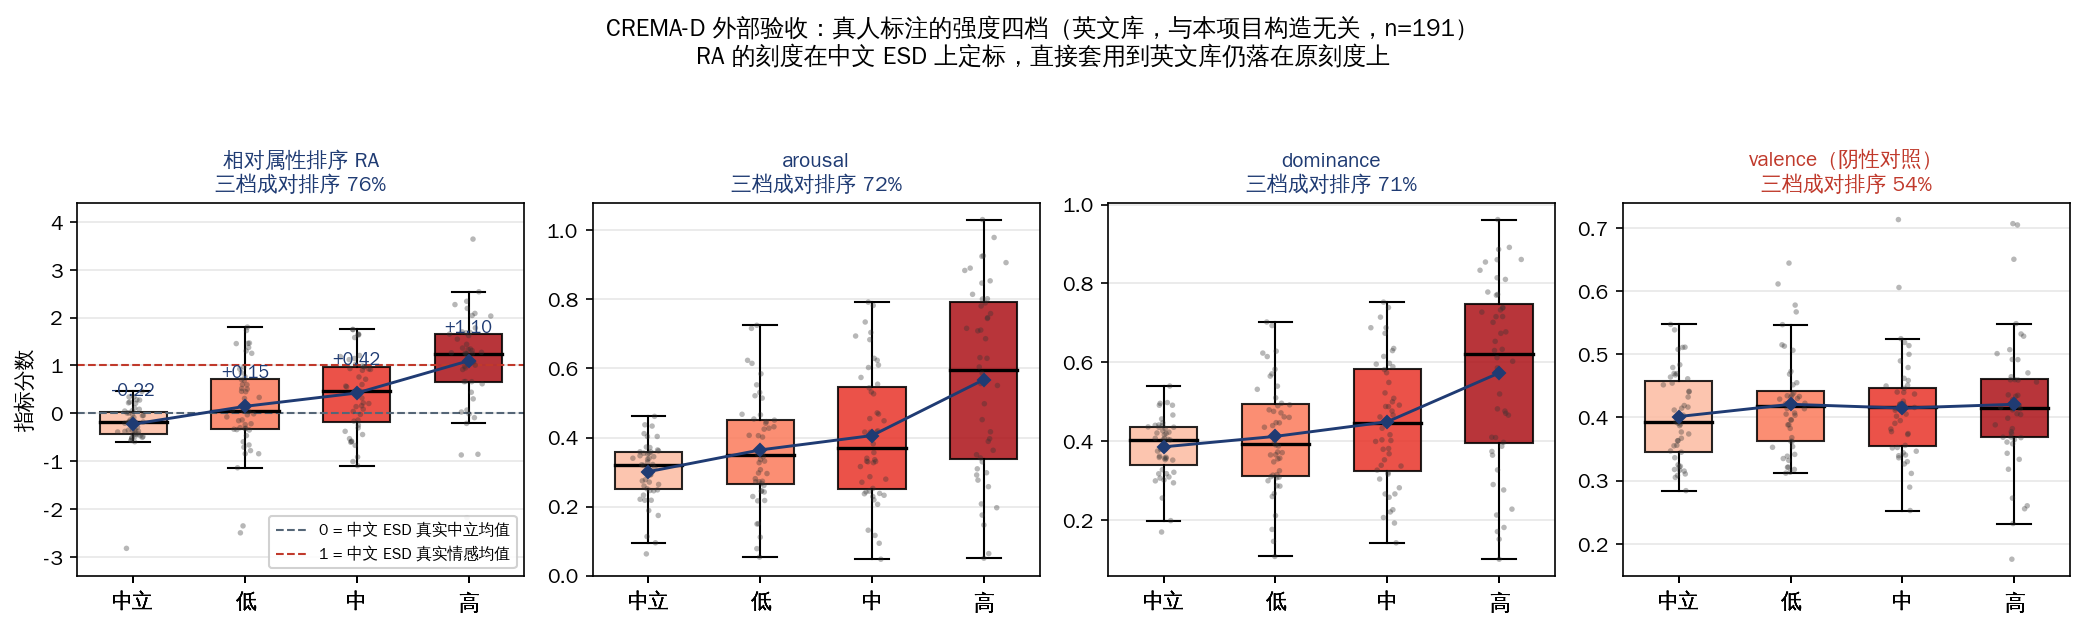
| 指标 | 中立 | 低 | 中 | 高 | 三档成对排序准确率 | ρ(四档) |
|---|---|---|---|---|---|---|
| 相对属性排序 | −0.22 | +0.15 | +0.42 | +1.10 | 76% (109/144) | +0.52 |
| arousal | 0.30 | 0.36 | 0.41 | 0.56 | 72% | +0.38 |
| dominance | 0.38 | 0.41 | 0.44 | 0.57 | 71% | +0.33 |
| valence(阴性对照) | 0.40 | 0.42 | 0.41 | 0.42 | 54%(≈随机) | +0.07 |
三条读法
- 🔑 刻度跨语言迁移:排序器的 0 和 1 是在中文 ESD 上定标的, 直接套到英文 CREMA-D,中立档落在 −0.22、最高档落在 +1.10 —— 基本原样迁移。这比单看"76% 排序准确率"强得多
- ✅ 两个指标都显著超过随机(76% / 72%,随机 50%)⇒ 不是自我循环的产物
- ✅ valence 恰好落在随机线(54%) ⇒ 阴性对照成立:测的是"强度"这一维度, 而非泛泛的音频差异
诚实的限度:76% 不算高。CREMA-D 的 LO/MD/HI 区分对人本身就难, 这个数字应读作"方向正确、可用于相对比较",而非"精确测强度"。本地只有 191 条,样本量偏小。
4.4 构造阶梯上的方法自检¶
| 指标 | ρ全局 | ρ组内 | CCC |
|---|---|---|---|
| 相对属性排序 | 0.590 | 0.787 | 0.302 |
| arousal | 0.485 | 0.771 | 0.257 |
| dominance | 0.387 | 0.604 | 0.153 |
| valence(对照) | −0.013 | 0.004 | 0.006 |
两个指标都能读出构造的已知强度,valence 归零。⚠️ 全局 ρ 低于组内, 正是 §2.3 说的说话人基线问题(此阶梯为单说话人,故全局/组内差异主要来自条间差异)。
5 结论¶
| 项 | 结论 |
|---|---|
| 旧指标 | ❌ emotion2vec 分类概率不能测强度(92% 饱和、AUC 0.618);delta 读数只作"是否翻转"用 |
| 指标方案 | ✅ 相对属性排序(主)+ arousal(副),均有文献出处 |
| 外部效度 | ✅ CREMA-D 真人标注上四档 −0.22/+0.15/+0.42/+1.10,成对排序 76%;valence 54% 阴性对照 |
| α=0 | ✅ 与真实中立录音不可区分(0.091 vs 0.082) |
| α=1 | ✅ 达真实情感强度的 89% |
| 刻度线性度 | ⚠️ α=0.25 只兑现 66–70%,其余档接近等间隔;ρ组内 0.91、中心化 CCC 0.85–0.86(160 条与 1276 条一致;此前的 0.537 未剔除退化值,已订正) |
| arousal 的限度 | ⚠️ α≥0.5 后饱和 ⇒ 不用于档位分辨 |
| 悲伤 | ⚠️ 三处一致例外(d′ 最低、α=0 起点最高、α=1.5 回落)⇒ 架构天花板,见 E7 |
6 复现¶
source scripts/env.sh
# 排序器(RankSVM on eGeMAPS)
$PY emo/exp/M17_editor/m21_e2b_ranker.py
# α 网格生成与打分(复用 E7 的 160 条 ESD test)
CUDA_VISIBLE_DEVICES=0 $PY emo/exp/M17_editor/m21_e2e_alphagrid.py
CUDA_VISIBLE_DEVICES=0 $PY emo/exp/M17_editor/m21_e2e_score.py
# CREMA-D 外部验收
CUDA_VISIBLE_DEVICES=0 $PY emo/exp/M17_editor/m21_e2f_crema_perclip.py
# 配图
$PY emo/exp/M17_editor/m21_e2e_plot.py && $PY emo/exp/M17_editor/m21_e2_figs.py
产物:outputs/m21/e2b/{ranker,crema_perclip}.json、outputs/m21/e7/alphagrid_scores.json。
订正记录(2026-09-03)
- 旧「模型 α 扫描」列已废:原建在 E4 的 P6 11 条上,而那 11 条当初是为 试听挑的、非随机抽样。α=0 在其上打 0.446,在 160 条随机样本上是 0.091; 自助检验显示从 160 条抽 11 条能抽到 ≥0.446 的概率仅 2.6%。 受影响的旧数字:ρ组内 0.927、CCC 0.451。
- 采样率不一致:E4 输出 24 kHz,排序器训练于 16 kHz。逐条影响达 ±0.5, 但均值几乎不变(0.446 → 0.441),故非上条的主因。现已统一 16 kHz。
- 自建指标降级:初版曾用"emotion2vec 嵌入投影到中立→情感方向"(ρ 0.905)。 该方法为自创、需配对中立版、端点被构造钉死,降级为内部诊断,不作为对外口径。
- 声学载体结论已移交 E7:本页初版基于构造阶梯得出"F0 主导", 系阶梯按 F0 插值构造的循环产物,已被 E7 的非循环测量推翻 (实际排序为 响度 > 谱斜率 > MFCC > F0)。