探针 · 电音归因与上限(M19–M20 共用)¶
| 状态 | ✅ §1–4 完成(2026-08-30,WSOLA 归因)· ✅ §5 追加(2026-09-01,GT mel 插值归因) |
| 一句话 | 把「数据侧目标」和「声码器往返」单独拿出来打分与试听——在不训练任何模型的前提下,界定 M19 的 MOS / delta 天花板,并定位残余电音的来源 |
| 上游 | ← M19:MOS 卡在 ~1.9、α=0 与中段仍有电音 · M20:中段 α 电音的归因(§5) |
TL;DR¶
电音主犯是 WSOLA 重合成的中立目标,不是模型也不是声码器。
- 🎯 声码器无罪:HiFT(情感 mel) UTMOS 2.61 ≈ 情感原录音 2.54——mel→波形这一段几乎无损
- 🔪 WSOLA 目标掉 0.52 MOS:均匀 R3 目标 3.33 → DTW-WSOLA 目标 2.81; mel 空间同口径,重合成伪影占 M19 残差能量的 24%(0.078 中有 0.018 不是情感)
- 📏 UTMOS 对情感语音有约 −1.0 的系统偏置:自然中立原录音 3.55 vs 情感原录音 2.54—— "MOS 1.9"必须按这把尺子读;M19 90k 的 MOS@α=1 = 2.55 已贴住 2.61 的上限
- 📈 delta 天花板 = 0.885(不是 1.0):90k 实测 0.835 = 达成 94%
- ⇒ 下一刀:分段 RubberBand R3 重建中立目标(按 DTW 锚点切段、每段 R3 均匀拉伸后拼接), 预期收回目标端约 0.5 MOS,同时把残差里那 24% 的伪影负担还给情感
1 方法¶
不训练、不推理,只做「数据 → mel → HiFT → 打分」:
D_emo    情感原录音                       绝对参照
D_neu    自然中立原录音                    UTMOS 的情感偏置标定
V_emo    HiFT(x1_emo)                    α=1 的「完美模型输出」
V_neu19  HiFT(x1_neu of m19_cache)       α=0 的完美输出(DTW+WSOLA 目标)
V_neu13  HiFT(x1_neu of m13_cache)       同上(均匀 R3 目标,M18 口径)
打分模块与主评测同源(emotion2vec_plus_large / UTMOS),n = 175 对(48 组 × ≤4 情感,test 划分)。
2 结果¶
2.1 上限表¶
| 臂 | emo 分(对目标情感) | UTMOS | 读法 |
|---|---|---|---|
| D_emo 情感原录音 | 0.998 | 2.54 | 真人情感语音的 UTMOS 就只有这么高 |
| D_neu 自然中立原录音 | 0.000 | 3.55 | 同一批人、同样是真录音,中立高出 1.02 |
| V_emo = HiFT(x1_emo) | 0.995 | 2.61 | α=1 的天花板;≈ 原录音 ⇒ 声码器无罪 |
| V_neu13 = HiFT(均匀 R3) | 0.121 | 3.33 | M18 的 α=0 天花板 |
| V_neu19 = HiFT(DTW-WSOLA) | 0.110 | 2.81 | M19 的 α=0 天花板——比 R3 低 0.52 |
2.2 与模型实测对照¶
| 天花板 | M18-λ1.0 实测 | M19 90k 实测 | 达成率(对 M19 天花板) | |
|---|---|---|---|---|
| MOS@α=1 | 2.61 | 2.81 | 2.55 | 98% |
| MOS@α=0 | 2.81(M19)/ 3.33(M18) | 2.77 | 2.00 | 71% |
| delta | 0.885(M19)/ 0.873(M18) | 0.911 | 0.835 | 94% |
- α=1 端 M19 已无空间可挖;M18 的 2.81 甚至越过了本口径的天花板(UTMOS 偏爱平滑语音)
- 缺口集中在 α=0:天花板本身被 WSOLA 砍掉 0.52,模型又只兑现了其中 71%
- delta 的"差 M18 一截"有一半是天花板差异,实际达成率 94%
2.3 mel 空间的同一结论(n=200)¶
| 中立目标构造 | GT 残差能量占比 |
|---|---|
| 均匀 R3(m13) | 0.1155 |
| DTW + WSOLA 重合成(m19) | 0.0777 |
| DTW 路径配对原始中立帧(不重合成) | 0.0580 |
差值 +0.018 = M19 残差能量的 24% 是 WSOLA 重合成伪影,不是情感信息—— v_B 必须学它、v_Δ 必须减掉它,两塔的容量都被这部分吃掉。
3 试听 0001_text00010「不是,他住在沃斯盾的老房子里。」¶
自然中立原录音:
| 情感 | 情感原录音 | HiFT(情感 mel) | HiFT(均匀 R3 中立) | HiFT(DTW-WSOLA 中立) |
|---|---|---|---|---|
| Angry | ||||
| Happy | ||||
| Sad | ||||
| Surprise |
第 2 列 ↔ 第 3 列:声码器往返的损耗(很小)。 第 4 列 ↔ 第 5 列:同一句中立、同样过声码器,唯一差别是变速引擎—— WSOLA 的 overlap-add 相位毛刺就是模型 α=0 输出里那层金属感的来源。
4 结论与下一刀¶
| 项 | 结论 |
|---|---|
| 声码器 / mel 表征 | ✅ 无罪:往返损耗 ≈ 0(2.61 vs 2.54) |
| WSOLA 变速 | ❌ 主犯:目标端 −0.52 MOS、残差能量里 24% 是伪影 |
| 模型本身 | α=1 已达 98% 天花板;α=0 兑现 71%,仍有空间但先修目标 |
| UTMOS 口径 | 对情感语音系统性低 ~1.0 分——跨情感/中立比较 MOS 时必须记住 |
| 建议 | ✅ 已实现并实测 → R3 试听页(UTMOS 2.78→3.05,对齐不变)。原设想的分段 RubberBand R3 重建 x1_neu:按 DTW 锚点切段 → 每段 R3 引擎均匀拉伸 → 拼接。 绕开 pylibrb 的 keyframe-map binding bug,同时拿回 R3 的音质(3.33 档)与 DTW 的对齐(≤1 帧)。 代价:段界处需交叉淡入淡出,缓存重建约 1 小时;训练可从 90k ckpt 续,不必从零 |
5 追加探针:GT mel 插值(2026-09-01)¶
问题:中段 α(0.25–0.5)的电音,是模型分离不够好,还是"情感 = 中立 + α·Δ"这个 建模假设本身在中段失效?
方法:完全不含模型——直接取 GT 的中立 mel 与情感 mel 按 α 线性混合,过 HiFT 打分。 n = 48 对(test 划分)。附一个对照臂:在功率域平均(exp → 加权和 → log)而非 log 域。
| α | GT 混合(log 域) | GT 混合(功率域) | 参照:M20@380k 模型输出 | GT 混合的情感分 |
|---|---|---|---|---|
| 0.0 | 3.14 | 3.14 | 2.80 | 0.212 |
| 0.25 | 2.07 | 2.36 | 1.89 | 0.385 |
| 0.5 | 1.42 | 1.74 | 1.54 | 0.656 |
| 0.75 | 2.02 | 1.47 | 2.09 | 0.957 |
| 1.0 | 2.79 | 2.79 | 2.65 | 0.985 |
5.1 结论:中段电音与模型无关¶
- α=0.5 处 GT 混合只有 1.42,低于模型输出的 1.54—— 模型在中段已达到、甚至略微超过这个目标定义所允许的上限
- V 形谷(3.14 → 1.42 → 2.79)在零模型参与下就存在,与对齐引擎(M18 均匀 R3 / M19 WSOLA / M20 R3 三种)无关、与训练量(40k–420k)无关
- ⇒ 病根在插值公式:
中立 + α·Δ ≡ (1−α)·中立 + α·情感, 这要求 Δ 是一个可缩放的加性位移。该假设对"某频率上有多少能量"(谱倾斜、响度)成立, 对"能量长在哪个频率上"(基频谐波、共振峰位置)不成立—— 位移乘 0.5 不会把谱峰移到中间,而是把一个峰变成两个半高的峰, 声码器只能把它渲染成金属感(听觉上像两个人同时说同一句话) - 这也解释外推为何反而好:α=1.5 的权重是 (−0.5, +1.5),一方绝对主导、另一方被减去(类似锐化), 仍像一个人说话;α=0.5 两边等权,谁也不主导,歧义最大 —— 故谷底精确落在 0.5
5.1b 机理图解:两套梳齿 vs 一套梳齿¶
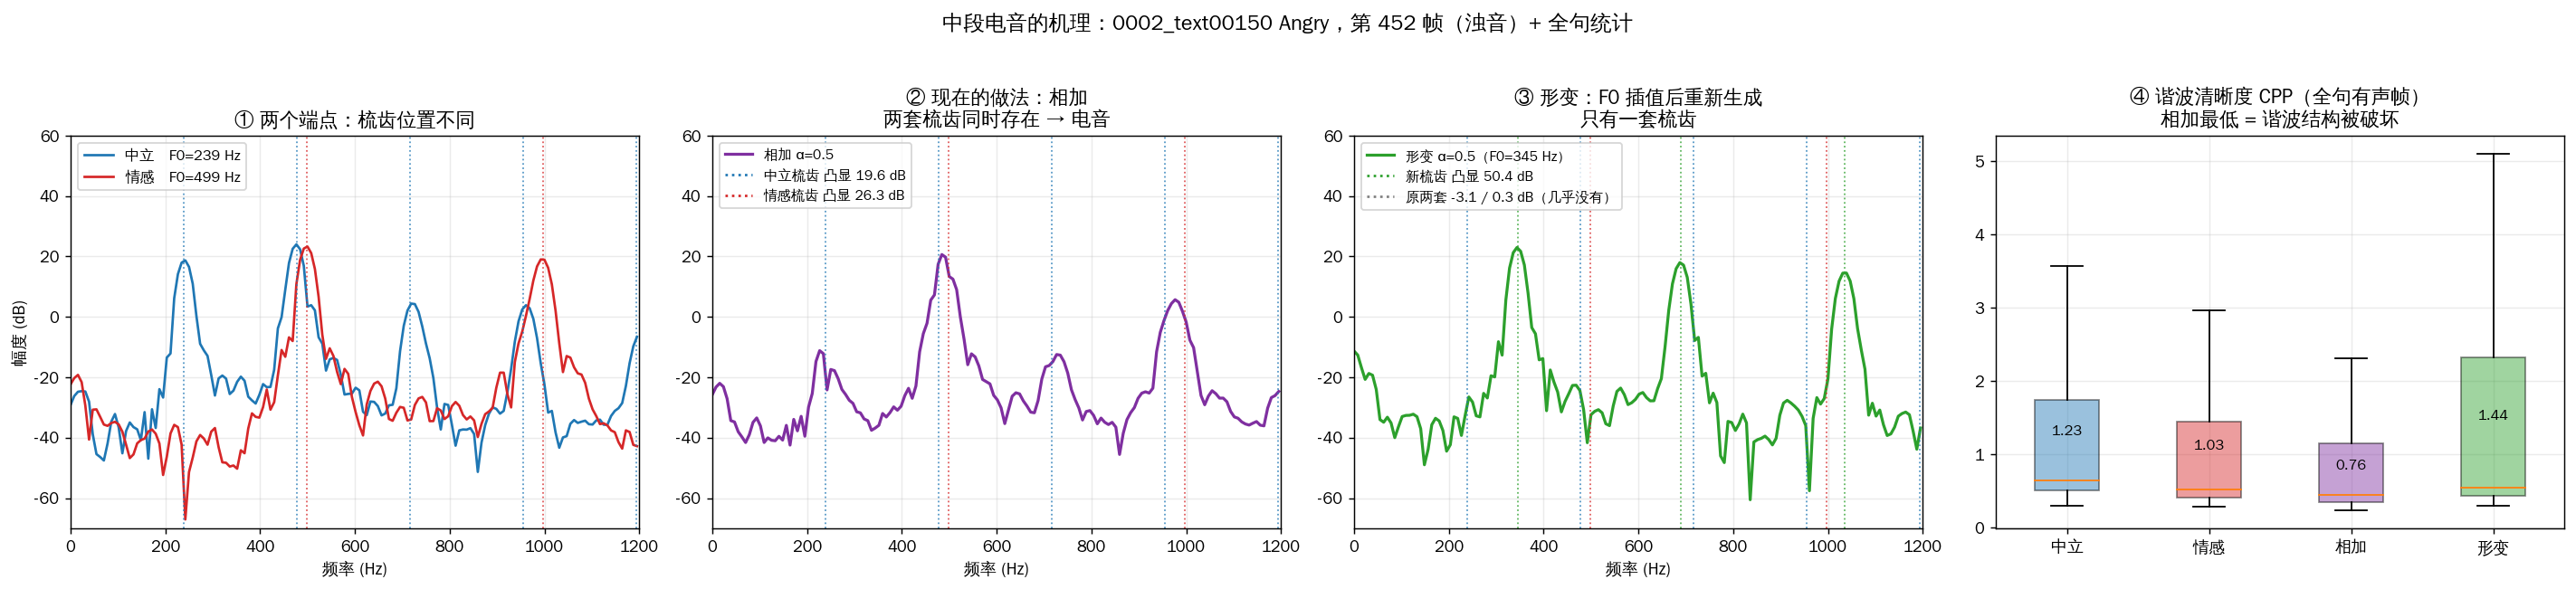
取 0002_text00150 Angry 的第 452 帧(浊音,两边都发声)。该帧中立的基频 239 Hz、
情感的 499 Hz——谐波(梳齿)位置完全不同。
量化:各条谱在三套梳齿位置上的"凸显度"(谐波峰 − 相邻谷,dB,越高表示该套梳齿越明确):
| 谱 | 在中立梳齿(239Hz) | 在情感梳齿(499Hz) | 在形变梳齿(345Hz) |
|---|---|---|---|
| 中立 | 37.0 | 1.4 | −14.6 |
| 情感 | 2.1 | 51.2 | −8.4 |
| 相加(现在的 α=0.5) | 19.6 | 26.3 | −11.5 |
| 形变(F0 插值后重新生成) | −3.1 | 0.3 | 50.4 |
- 两个端点各自只有一套梳齿(37.0/1.4 与 2.1/51.2)
- 相加后两套梳齿同时存在(19.6 与 26.3)——这就是"双重曝光",听觉上像两个人同时说话
- 形变后只有新的一套(50.4),原来两套几乎归零(−3.1 / 0.3)
跨全句的验证(CPP 谐波清晰度,有声帧):中立 1.23 · 情感 1.03 · 相加 0.76(最低) · 形变 1.44(最高)。 相加破坏谐波结构不是个别帧的现象,是全句性的。
为什么 WORLD 的插值不会产生双梳齿:它把语音拆成 F0 / 谱包络 / 非周期成分三样, 而谱包络里不含梳齿(CheapTrick 估计时已抹掉谐波纹波)。梳齿只在合成那一刻由单个 F0 值现场生成, 因此包络相加是安全的。mel 谱则把梳齿与包络揉在一起,平均 mel 就把梳齿一并平均了。
"位置类"的量其实有两个(本轮只治了主因):
| 量 | 谁决定 | 线性平均的后果 | 严重程度 |
|---|---|---|---|
| 谐波位置 | F0(= 梳齿间距) | 两套尖梳齿并存 | 主因(齿尖、数量多) |
| 共振峰位置 | 谱包络里的宽包 | 宽包变胖/出双峰 | 次要(包宽,听感偏"闷"而非"电") |
| 各频段能量大小 | 包络高度 | 无问题 | — |
完整的形变(STRAIGHT 式)会把包络的频率轴也一并 warp,把次因也治掉;本轮未做。
⚠️ 一处实测到的限制:谱包络只能在谐波位置上被采样到。本例情感侧 F0=499 Hz, 1000 Hz 以下仅两根谐波,包络在低频是欠定的(共振峰测不准)。 高音调语音的谱采样本就稀疏——这也是 mel 域混合在高激动度语音上更吃亏的原因之一。
5.1c 试听:同一条 mel→HiFT 路径,只差插值方式¶
| α=0.5 音频 | |
|---|---|
| 相加(现在的做法) | |
| 形变(F0 对数插值 + 包络线性插值,WORLD 合成后同样过 mel→HiFT) |
两条都是纯 GT 数据、都经过 mel → HiFT,唯一差别是 mel 怎么造出来的。
5.1d 候选修法的基础操作:倒谱截断¶
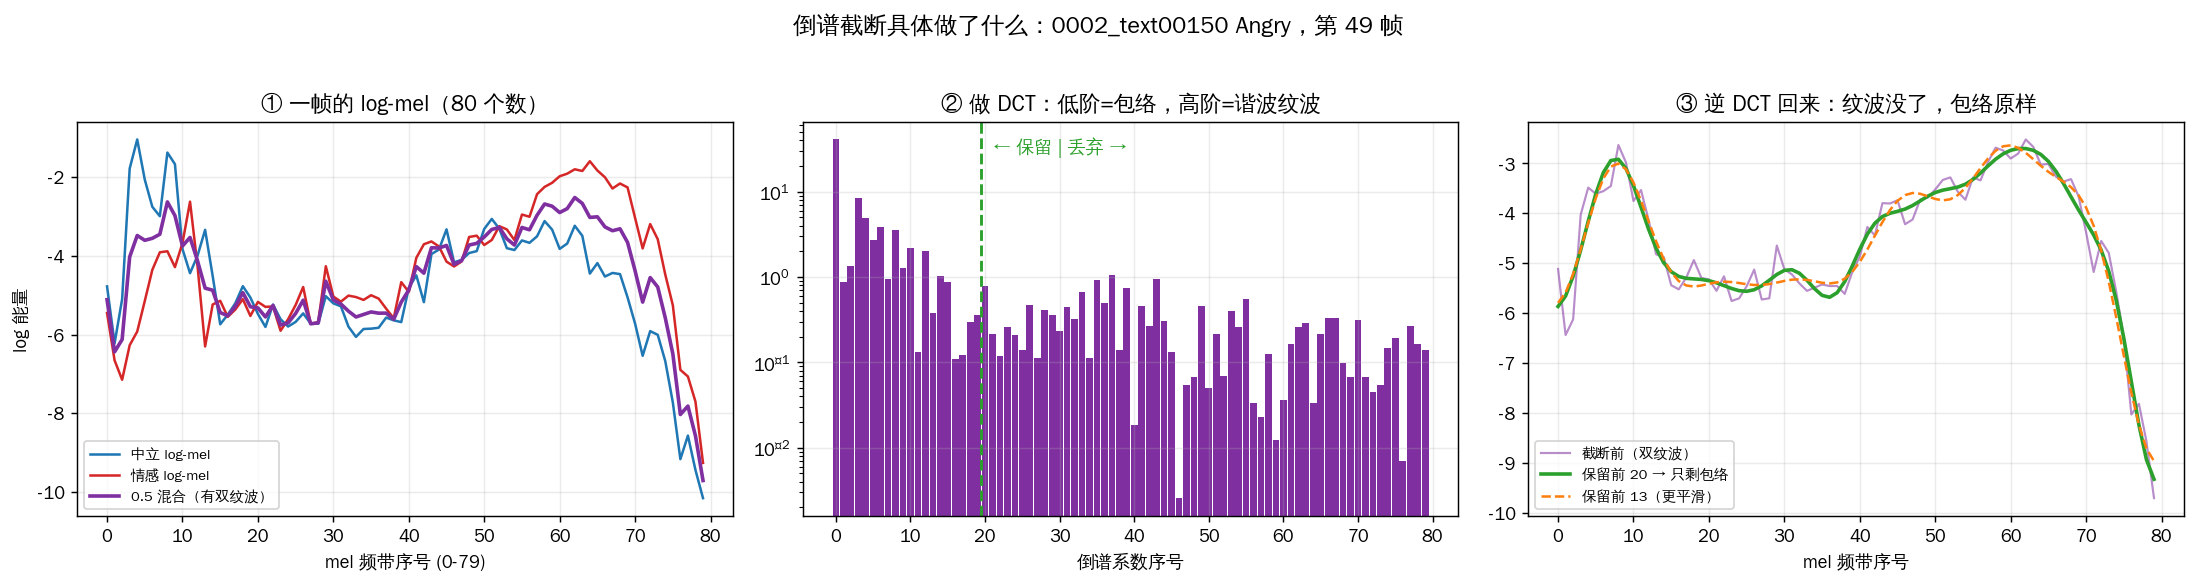
若要在推理端修掉双梳齿,最基础的一步是把 mel 里的"包络"与"谐波纹波"分开。 mel 域的标准做法是倒谱截断(即 MFCC 只取前若干维的同一原理):
① 取一帧 log-mel(80 个数)
② 做 DCT → 80 个倒谱系数:低阶 = 沿频率轴变化慢的成分(包络/共振峰)
                          高阶 = 变化快的成分(谐波梳齿)
③ 高阶置零 → 逆 DCT 回到 80 维:纹波消失、包络原样
实测(0002_text00150 Angry 第 49 帧):
| 量 | 数值 |
|---|---|
| 第 0 个倒谱系数占总能量 | 91.6% |
| 前 13 个 / 前 20 个 | 99.5% / 99.6% |
| 第 20 个之后(被丢弃的全部纹波) | 仅 0.4% |
| 截断后与原始的 RMS 差(log-mel 单位) | 保 20:0.313 · 保 13:0.354 |
- 丢掉的信息很少(0.4% 能量),包络完整保留——回应"截断是不是丢太多"的疑虑
- 但 0.4% 的能量 ≠ 0.4% 的听感权重:谐波结构正属于"能量小、听感关键"的细节, 所以单纯截断不够,还需把正确的单套梳齿加回来(由 HiFT 的正弦源按插值 F0 生成)
- 图①另可看出:双梳齿主要存在于前 15–20 个 mel 频带;第 40 带以上带宽已超过谐波间距, 那里的起伏是真实谱形而非梳齿 ⇒ 更稳妥的做法可能是只在低频段截断
⬜ 上述修法(注入 F0 / 频率平滑 / 倒谱截断 / 组合)尚未跑完整对照实验。
5.2 插值域是个便宜的改进方向¶
功率域平均在 α=0.5 白捡 +0.32(1.42 → 1.74)、α=0.25 +0.29;但 α=0.75 反而掉 (2.02 → 1.47),故不能直接替换。它证明的是:插值域的选择本身就能显著改变中段音质, 值得作为下一步的低成本实验(例如按频带分别选择插值域,或基频与包络分开插值)。
5.3 试听(0002_text00150 Angry,全 GT 混合,无模型)¶
原始录音参照(未过声码器):情感 自然中立
下表中 α=0 与 α=1 两列即为 GT(GT mel 直接过 HiFT,无模型);注意 α=0 是R3 对齐后的中立(训练目标),与上面的自然中立在节奏上不同。
| α | log 域混合 | 功率域混合 |
|---|---|---|
| 0.00 | ||
| 0.25 | ||
| 0.50 | ||
| 0.75 | ||
| 1.00 |
另两组(0009_text00160 Sad、0001_text00010 Happy)同名文件在
media/audio/gtinterp/ 下,命名规则 <key>_<情感>_a<α>_<log|pow>.mp3。
读法:α=0 与 α=1 是真实录音的 mel 经声码器往返(3.14 / 2.79), 中间三档是纯粹的数学混合——它们听起来有多糟,就是这条建模路线在中段的天花板有多低。
6 中段修法的四轮实验(2026-09-01)¶
§5 证明中段电音源于加性插值假设失效。本节记录尝试过的四类修法,三负一正。
6.1 ❌ 注入 F0(绕过 HiFT 的 F0 预测器)¶
HiFT 是源–滤波器(HnNSF)结构:f0_predictor 从 mel 预测 F0 → SineGen 生成谐波源 → 网络滤波。
猜想:双梳齿让 F0 预测器锁不住音高,直接注入插值 F0 即可修复。
在 M20@420k 模型输出上实测(mel 完全不动,只换源的 F0):
| α | 0 | 0.25 | 0.5 | 0.75 | 1.0 |
|---|---|---|---|---|---|
| Angry 现状(两端差 10.9 半音) | 3.42 | 2.67 | 1.57 | 1.92 | 2.37 |
| Angry 注入 F0 | 3.27 | 2.35 ↓ | 1.69 | 1.93 | 2.50 |
| Sad 现状(两端差 0.1 半音) | 3.47 | 2.65 | 2.06 | 2.73 | 3.14 |
| Sad 注入 F0 | 3.44 | 2.69 | 2.06 | 2.84 | 3.11 |
结论:无效。 即使在音高差 10.9 半音的最坏情形,α=0.5 也只 +0.12(噪声量级),α=0.25 反而 −0.32。 ⇒ 在 HiFT 里 mel 说了算,源修对了也救不回来。
附带发现:Sad 那组两端 F0 几乎相同(0.1 半音,无双梳齿)却照样有中段谷 (2.06 vs 端点 3.47/3.14)——双梳齿不是唯一成因。 60 对统计:两端 F0 差异中位 4.8 半音、72% >3 半音,故 Sad 属少数派,但它证明还存在第二成因。
6.2 ❌ 抹平 mel(五种由轻到重,全部有害)¶
保留全部插值,只把并存的双齿抹成单齿。同时在 α=0/1(本无双齿)上施加同样处理以量化伤害:
| 臂 | 中段 MOS | vs 基线 | 端点 MOS | vs 基线 |
|---|---|---|---|---|
| A 现状 | 2.07 | — | 2.96 | — |
| 高斯 σ=1 频带 | 1.46 | −0.61 | 1.68 | −1.28 |
| 高斯 σ=1.5 | 1.36 | −0.71 | 1.39 | −1.56 |
| 中值滤波 3 点 | 1.51 | −0.56 | 1.77 | −1.18 |
| 只抹低频 25 带 | 1.48 | −0.59 | 1.79 | −1.16 |
| 倒谱软加权 | 1.51 | −0.56 | 1.71 | −1.24 |
结论:没有"伤害较小的方法",五种全负。 与 §5.1d 的测量一致—— 混合谱的纹波本就比真实语音少 25%(RMS 0.58 vs 0.74),再减只会更off-distribution。 ⇒ HiFT 既依赖 mel 的精细结构、又对它敏感,任何"减法"式修补都砸音质。
6.3 ✅ 先对齐音高再混合(用户方案,唯一正向)¶
不修 mel、不动插值,而是在混合之前把两端的音高都变到目标值,使梳齿天然重合:
中立 ──WORLD 分解──> (F0_n, 包络_n, 非周期_n) ──用 F0_α 重合成──> A'
情感 ──WORLD 分解──> (F0_e, 包络_e, 非周期_e) ──用 F0_α 重合成──> B'
mel_α = (1−α)·mel(A') + α·mel(B')  ──> HiFT
其中  F0_α = exp( (1−α)·log F0_n + α·log F0_e )      ← 按 α 插值,非固定平均
F0 目标随 α 变化(以 239↔499 Hz 为例):
| α | 0 | 0.25 | 0.5 | 0.75 | 1.0 |
|---|---|---|---|---|---|
| F0 目标 (Hz) | 239 | 288 | 345 | 416 | 499 |
实测(3 条,GT 数据):
| α | 基线(直接混合) | 音高对齐后混合 | 差 |
|---|---|---|---|
| 0.0 | 3.42 | 2.88 | −0.55 ← WORLD 往返损耗 |
| 0.25 | 2.55 | 2.55 | +0.01 |
| 0.5 | 1.68 | 2.17 | +0.49 |
| 0.75 | 2.07 | 2.20 | +0.13 |
| 1.0 | 2.58 | 2.07 | −0.51 ← WORLD 往返损耗 |
逐条:Angry(差 9.6 半音)+0.77 · Happy(差 10.4)+0.29 · Sad(差 1.2)+0.41 —— 音高差越大收益越大,与机理预测一致。
关键读法:α=0/1 处目标 F0 即其自身、并未变调,掉的 0.5 分纯粹是 WORLD 分解→重合成的往返损耗(固定开销)。倒扣这笔开销后,音高对齐本身在 α=0.5 值约 +1.0 分。 而两端本就不需要走这条路 ⇒ 实际策略是"两端走直路、中段走对齐路":
| α | 0 | 0.25 | 0.5 | 0.75 | 1.0 |
|---|---|---|---|---|---|
| 原来 | 3.42 | 2.55 | 1.68 | 2.07 | 2.58 |
| 混合策略 | 3.42 | 2.55 | 2.17 | 2.20 | 2.58 |
试听:α 从 0 到 1 的完整对拍¶
先验证"只换 F0、音色不动"(0002_text00150):
| 中立原音(F0≈243,时间已对齐) | 只把 F0 换到 328 | 情感原音(F0≈499) |
|---|---|---|
中间那条应当听起来是同一个人、同一句话、同样的音色,只是音调升高。 若听感上变了个人,说明变调不够干净(重新分析的包络与原包络 RMS 差 5.2 dB, 作参照中立↔情感的包络差为 16.0 dB)。
α 全网格对拍(左=现状直接混合,右=先对齐音高再混合;括号内为 UTMOS):
0002_text00150 Angry —— 两端 F0 差 9.6 半音****
| α | 现状(直接混合) | 音高对齐后混合 | 差 |
|---|---|---|---|
| 0.00 | 3.83 |
2.87 |
-0.96 ←端点,无变调,差值即 WORLD 往返损耗 |
| 0.25 | 2.33 |
2.49 |
+0.16 |
| 0.50 | 1.46 |
2.23 |
+0.77 |
| 0.75 | 2.09 |
2.30 |
+0.21 |
| 1.00 | 2.65 |
1.92 |
-0.73 ←端点,无变调,差值即 WORLD 往返损耗 |
0009_text00160 Sad —— 两端 F0 差 1.2 半音(反例:几乎无音高差)
| α | 现状(直接混合) | 音高对齐后混合 | 差 |
|---|---|---|---|
| 0.00 | 3.65 |
3.06 |
-0.59 ←端点,无变调,差值即 WORLD 往返损耗 |
| 0.25 | 3.19 |
2.77 |
-0.42 |
| 0.50 | 2.26 |
2.67 |
+0.41 |
| 0.75 | 2.51 |
2.80 |
+0.29 |
| 1.00 | 3.21 |
2.67 |
-0.54 ←端点,无变调,差值即 WORLD 往返损耗 |
0010_text00310 Happy —— 两端 F0 差 10.4 半音****
| α | 现状(直接混合) | 音高对齐后混合 | 差 |
|---|---|---|---|
| 0.00 | 2.79 |
2.70 |
-0.09 ←端点,无变调,差值即 WORLD 往返损耗 |
| 0.25 | 2.12 |
2.39 |
+0.27 |
| 0.50 | 1.32 |
1.61 |
+0.29 |
| 0.75 | 1.61 |
1.51 |
-0.10 |
| 1.00 | 1.89 |
1.61 |
-0.28 ←端点,无变调,差值即 WORLD 往返损耗 |
读法:两端(α=0/1)目标 F0 即其自身、并未变调,那里的差值是 WORLD 分解重合成的固定往返损耗; 中段的正收益是在倒扣这笔损耗之后得到的。实际部署应"两端走直路、中段走对齐路"。
全量评测已完成(2026-09-01)
本方案已在 11 组 × 7 α 上跑完 → 音高对齐混合 · 全量评测: 中段 α=0.5 的 MOS 从 1.58 抬到 2.21、α=0.25 从 1.94 到 2.48; 但外推档崩坏、CER 变差 ⇒ 仅应在 0<α<1 启用。
6.4 待办与风险¶
- ⬜ 样本量不足:仅 3 条,需扩到 12 组全 α 网格
- ⬜ 过路费可压:WORLD 往返 −0.5,换 RubberBand R3 变调(保共振峰,本项目已在用)可能更低
- ⚠️ 部署成本:需"两端 mel → 各自声码 → 变调 → 重提 mel → 混合 → 再声码", 比现状多两次声码 + 两次变调
- ⚠️ 情感分不可靠:混合音频上 emotion2vec 输出在 0.00/1.00 间跳变,情感是否保留须靠听感判定