M17 · 音频到音频:情感语音 → (中立 v, 情感 v)¶
| 状态 | ⚠️ 随机臂完成(未成声)→ 基座臂 M18 接跑中 |
| 一句话 | 甩掉 LLM/token/prompt 整条 TTS 管线:输入情感音频,frozen whisper-large-v3 encoder + 可训 adapter 出逐帧条件,双塔 DiT 分别重建情感 mel(v_A)与中立 mel(v_B),α 混合实现情感强度编辑 |
| 上游 | ← M16(双塔有效但受 LLM/token 管线约束:节奏钉死、软 token 梯度墙、α=0 乱说)· 用户提出音频到音频新架构 |
| 对照 | M16(80k,同双塔不同条件源)· M14-λ0 · v4 |
TL;DR¶
⬜ 待跑。任务从 TTS 变为情感编辑(audio-to-audio):训练输入 = 真实情感录音, 推理输入 = 真实情感录音——训推第一次完全同构;LLM 采样噪声、GT/LLM token 分布差、 离散 token 梯度墙、节奏被 LLM 钉死等问题整体删除。 条件从 25Hz 离散 token 升级为 50Hz 连续 whisper-large-v3 encoder 特征(本地已有,无需新下载依赖)。 中立目标沿用均匀 R3(复用 m13_cache),λ_ortho=0.1。40k 步试跑(用户指定)。
1 目的¶
用一段情感语音生成其对应的中立版与自身重建版,\(v(\alpha)=(1-\alpha)v_B+\alpha v_A\) 在同一时间轴上做情感强度编辑。系统内不再有文本、LLM 与离散 token。
2 实验设置¶
2.1 架构¶
情感音频 wav ─┬─→ frozen whisper-large-v3 encoder(最后一层 hidden,50Hz,1280d)
              │      └→ Adapter(Conv1d 1280→512, k3, GELU → Conv1d 512→80, k3)→ μ (80d/帧)
              ├─→ frozen campplus → xvector 192d → spks
              │
              z ~ N(0,I)(时间轴 = 输入音频 mel 帧网格,K 帧)
                     ├─→ DiT_A(y, μ, t, spks, cond≡0) → v_A   ←u_e(输入自身 mel)
                     └─→ DiT_B(y, μ, t, spks, cond≡0) → v_B   ←u_n(均匀 R3 中立 mel)
| 项 | 值 |
|---|---|
| 编码器 | whisper-large-v3 encoder(635M),冻结,最后一层 hidden;输入按 whisper 约定 pad 到 30s、只取有效帧;50Hz 与 mel 对齐,线性插值到 K |
| Adapter | 可训,~2.2M:Conv1d(1280→512,k=3)+GELU+Conv1d(512→80,k=3),输出顶替 μ 槽位 |
| DiT_A / DiT_B | CosyVoice DiT 架构各 331M,随机初始化(用户指定),无级联无残差无共享层 |
| prompt/前缀 | 删除:cond ≡ 0,无 in-context 参考 |
| 可训参数 | ≈663M(双塔 + adapter;whisper / campplus 冻结) |
| λ_ortho | 0.1(用户指定保留;A=v_A−v_B、B=v_B,80×80 时间轴归一化全对内积) |
2.2 数据¶
复用 data/m13_cache:x1_emo(情感 mel = 重建目标)、x1_neu(均匀 R3 中立 mel =
中立目标)、xvec_e。新增预提取:每条情感录音的 whisper encoder 特征(fp16,约 15GB,data/m17_whisper/)。前缀字段全部不用。
2.3 训练¶
1. 输入条件:μ = Adapter(whisper_enc(情感 wav)),spks = xvec_e,cond = 0,长度 K = 2N_e
2. 采样 t ~ U[0.05,0.95]、α ~ U[0,1];x_α = (1−α)x1_neu + αx1_emo
3. y = (1−(1−σ)t)z + t·x_α
4. v_A = DiT_A(y,…);v_B = DiT_B(y,…)
5. L = ‖v_A−u_e‖² + ‖v_B−u_n‖² + 0.1·L_ortho(A,B)
6. AdamW 联合更新双塔 + adapter,grad_clip=1.0
| 参数 | 值 |
|---|---|
| 步数 | 40,000(试跑)(全局 batch 8;whisper 特征离线预提,训练时零编码开销) |
| 并行 | DDP 8×1(同 M16) |
| lr / 优化器 | 1e-5 / AdamW(adapter 同 lr) |
| grad_clip / seed | 1.0 / 1234 |
| ckpt / 中途评测 | 每 10k 步;10k/20k/30k 各评一次(同 M16 协议) |
| 日志 | L_A、L_B、L_ortho、grad_norm、A_share、cos_A_B |
| 输出 | outputs/m17/ |
2.4 推理与评测¶
1. 输入 = held-out 的 GT 情感录音(P6 同 12 组的情感参考音频)
2. 编码一次 → 每 Euler 步双塔并行 → 生成段 v=(1−α)v_B+α·v_A(全长即生成段)
3. HiFT 声码
| 项 | 值 |
|---|---|
| 规模 | 12 组 × 7 α = 84 条(α=1 ≈ 输入重建,自检项;α=0 = 中立化,核心项) |
| 指标 | CER(对 GT 文本)· emotion2vec delta/受控/负向 · SECS(对输入说话人)· UTMOS 含按 α 分列 |
| 探针 | cos(A, x1_emo−x1_neu) teacher-forced(协议同 M14 §4.5)· A 结构 |
| 主判据 | MOS@α=0 轨迹(10k/20k/30k/40k)+ α≤0.5 的 CER(乱说是否复现) |
3 已知不确定点(跑前登记)¶
- α=0 乱说是否复现——首要风险。当前最强假设是"均匀变速目标与条件逐帧错位"; 本实验按用户决定沿用均匀 R3,若复现则后备臂 = 换 DTW 引导的 RB keyframe 目标, 一刀下去即可归因
- whisper encoder 为 ASR 目标训练,最后一层偏语义;若逐帧锚定不足,后备 = 取中层 hidden
- 随机起点 + 40k 步的音频可用性:E2 先例(token 条件、42.5k 步随机起点)音频不可用; 本实验条件换为连续 whisper 特征、任务换为编辑(含 α=1 重建监督),收敛性未知——40k 试跑即为此设
- 编码层选择(最后一层)写死为默认,未消融
- adapter 输出 80d 是为复用基座
input_embed而定,表达瓶颈风险低 - 任务域转为编辑:无文本合成能力;泛化到 ESD 外说话人/情感未测
- 时长锁在输入时间轴(中立版被压到情感节奏)——既有边界,非新债
4 资源¶
whisper 特征预提约 40 分钟(8 卡分片);训练 DDP 8×1 约 2 小时(40k 步、无前缀短序列); 中途评测共卡;终评 + 探针约 1 小时。
5 结果(随机初始化臂,40k)¶
轨迹(10k / 20k / 30k / 40k):
| step | delta | CER 总 | CER@α=0 | CER@α=1 | MOS | MOS@α=0 |
|---|---|---|---|---|---|---|
| 10k | 0.293 | 1.003 | 1.03 | 0.86 | 1.25 | 1.25 |
| 20k | 0.223 | 0.835 | 1.27 | 0.53 | 1.25 | 1.24 |
| 30k | 0.509 | 0.870 | 1.19 | 0.76 | 1.27 | 1.27 |
| 40k | 0.481 | 0.801 | 1.27 | 0.40 | 1.28 | 1.28 |
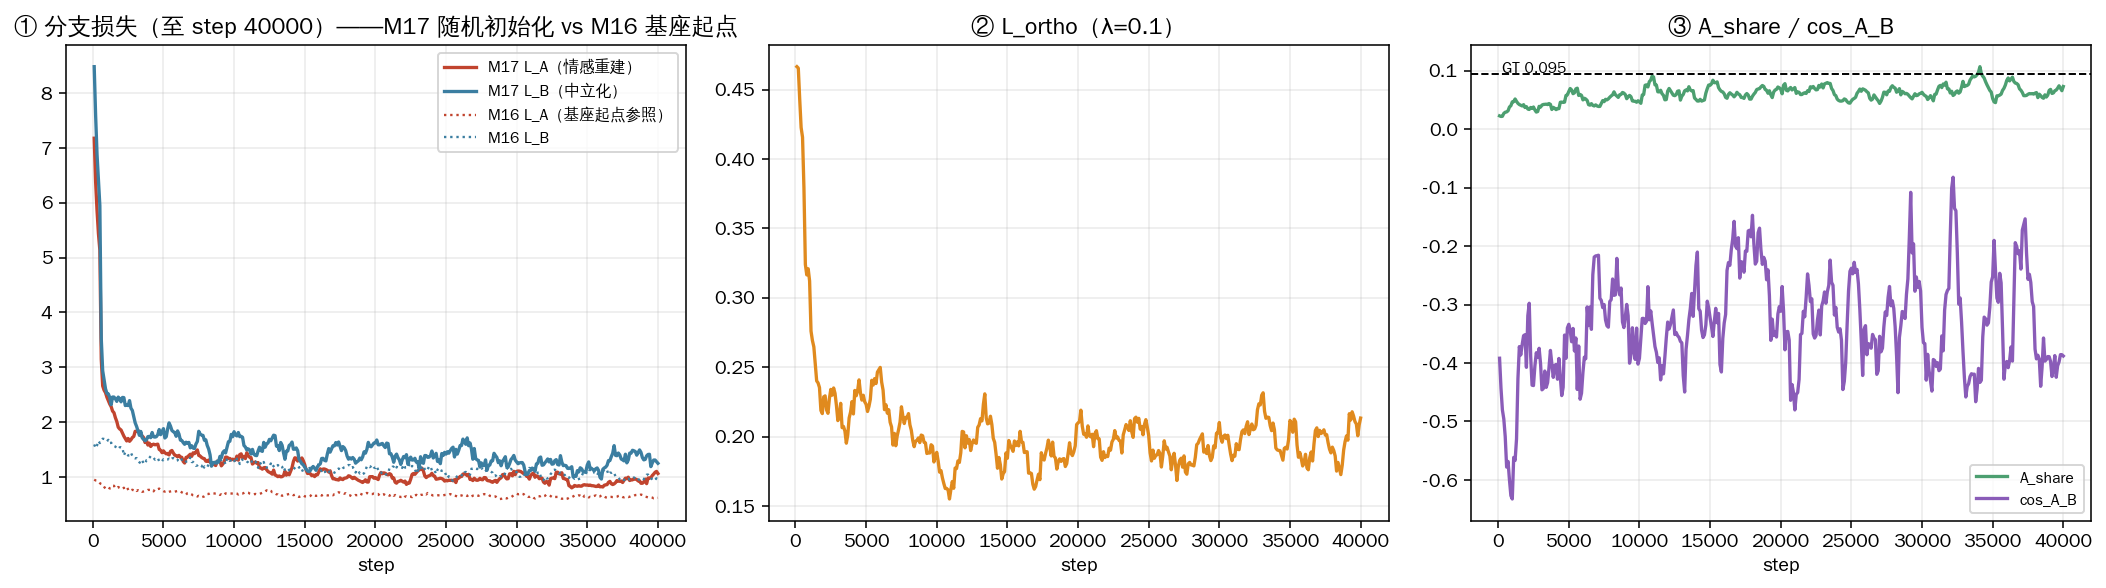
- 内容跟随确立但分层:情感端(α=1)CER 一路降到 0.40——whisper 连续条件的逐帧锚定生效; 中立端(α=0)停在 1.27——"中立化滞后于自我重建"的历代模式在随机起点重演
- 音质无拐点:MOS 全程 1.25–1.28 平线,未"成声"(用户听感:有内容、多电音); L_A 从 20k 起横盘 ~1.0(M16 基座起点同期 0.59)
- 正则观察:L_ortho 平在 ~0.19、cos_A_B ≈ −0.34——双塔靠监督分化出负相关,λ=0.1 未推动进一步分离 (λ 消融已排入 M18 链)
- 40k 终点音频(两 case × 7α,含 α=5)见快照页
6 结论(随机臂)¶
| 项 | 结论 |
|---|---|
| 架构可行性 | ✅ 管线通、内容学得动(CER@α1 0.40)——音频到音频 + whisper 条件的路线成立 |
| 随机初始化 | ❌ 25h 数据从零学不出语音纹理(MOS 1.28 平线)——与 E2 结论一致,条件换强也救不了 |
| 归因 | 电音 = 谱纹理缺失 = 基座预训练承载的那一层;零步验证(M18 §2)已证纹理先验可穿透新条件 |
| 下一步 | → M18:基座初始化同款重跑(λ=0.1 → 链式 λ=1.0 消融) |